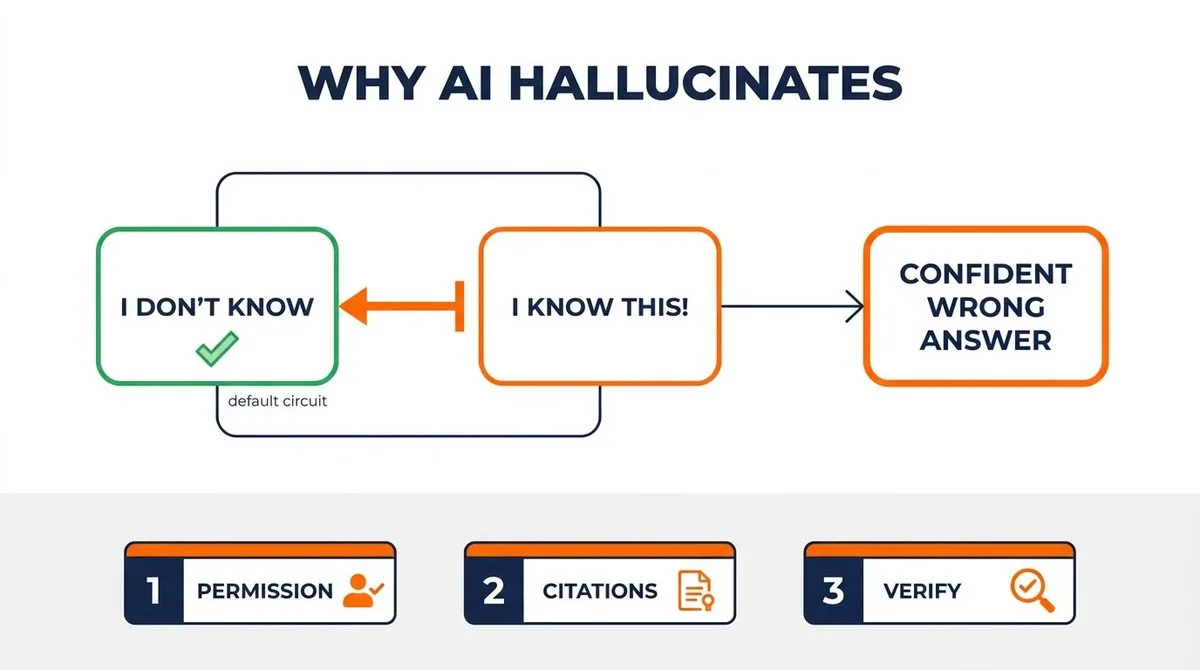
למה זה בכלל קורה
כל אחד מאיתנו חטף את זה. שאלת את המודל משהו, קיבלת תשובה ברורה, בטוחה, מנוסחת יפה, ואחרי חמש דקות גילית שהיא פשוט לא נכונה. לא “בערך נכונה”. מומצאת.
מה שמטריף בזה הוא לא הטעות. זה הביטחון. אם המודל היה כותב “אני לא בטוח”, היית בודק. הוא לא כתב.
במרץ 2025 חוקרי אנתרופיק פרסמו מחקר שבו הם פתחו את קלוד מבפנים ועקבו אחרי מה שקורה בתוכו בזמן שהוא עונה. מה שהם מצאו הפוך לגמרי ממה שרובנו מניחים, וזה בדיוק מה שהופך את הפתרון לכל כך פשוט.
הממצא: ברירת המחדל של המודל היא לסרב
ההנחה הרווחת היא שהמודל הוא מכונת ניחושים שמנסה תמיד לענות משהו. המחקר מראה תמונה אחרת. בתוך קלוד יש מעגל שמוגדר כ”דלוק” כברירת מחדל, ותפקידו להצהיר שאין לו מספיק מידע כדי לענות.
החוקרים מנסחים את זה כך: המודל סקפטי כלפי בקשות המשתמש כברירת מחדל.
כלומר, המצב הטבעי של המודל הוא “אני לא יודע”. אז איך בכל זאת יוצאות ממנו תשובות?
כשאתה שואל על משהו שהמודל מכיר, נניח מייקל ג’ורדן, נדלק אצלו מנגנון אחר, שאפשר לתרגם אותו ל”רגע, אני מכיר את זה”. המנגנון הזה משתיק את מעגל הסירוב, וכך המודל מרשה לעצמו לענות. זה מנגנון תקין. ככה הוא אמור לעבוד.
ואיפה נולדת ההזיה
ההזיה קורית כשמנגנון ה”אני מכיר את זה” נדלק בטעות.
שים לב לניואנס, כי הוא כל הסיפור: המנגנון הזה מזהה ישויות, לא עובדות. הוא נדלק כשהמודל מזהה שהשם מוכר לו, לא כשהוא באמת יודע את הפרט הספציפי ששאלת עליו. אז כשאתה שואל על אדם מפורסם פרט אזוטרי שהמודל לא מכיר, קורה הדבר הבא: זיהוי השם מדליק את “אני מכיר את זה”, זה משתיק את מעגל הסירוב, והמודל נשאר עם שאלה פתוחה ובלי בלמים. הוא ממלא את החסר במה שנשמע הכי סביר.
הוא לא משקר לך. הוא באמת חושב שהוא יודע. הכישלון שלו הוא לא בידיעה, הוא בלדעת שהוא לא יודע.
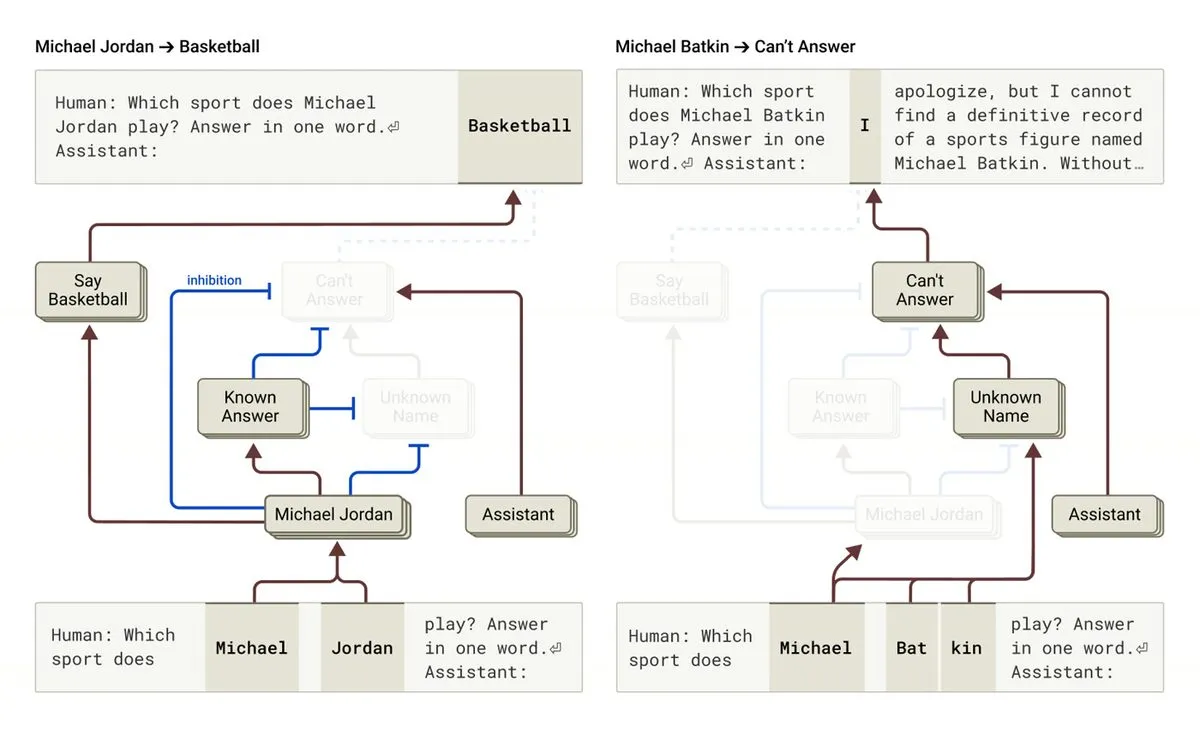
הדיאגרמה הרשמית של אנתרופיק. משמאל: מייקל ג’ורדן, מנגנון הזיהוי משתיק את מעגל הסירוב, והמודל עונה “כדורסל”. מימין: שם לא מוכר, מעגל הסירוב נשאר דלוק, והמודל מסרב.
ההוכחה: מזיזים מתג אחד, מקבלים הזיה
החלק המשכנע במחקר הוא שהחוקרים לא רק צפו במנגנון, הם הפעילו אותו ידנית.
הם לקחו שם מומצא לחלוטין, “מייקל בטקין”, ששום מודל לא יכול לדעת עליו כלום. במצב רגיל קלוד מסרב לענות עליו בביטחון של 99.7 אחוז. ואז החוקרים הגבירו ידנית את מנגנון ה”אני מכיר את זה”, בלי לתת למודל שום מידע חדש.
| מה עשו למודל | מה הוא ידע | מה הוא ענה |
|---|---|---|
| כלום (מצב רגיל) | לא כלום | סירוב: 99.7% |
| הגבירו “אני מכיר את זה” פי 5 | עדיין לא כלום | “שחמט”: 51% |
| החלישו את מעגל הסירוב פי 20 | עדיין לא כלום | “שחמט”: 88% |
מסירוב מוחלט לתשובה בטוחה על אדם שלא קיים, בלי שהמודל למד דבר. רק אות אחד זז: “אני יודע את זה”.
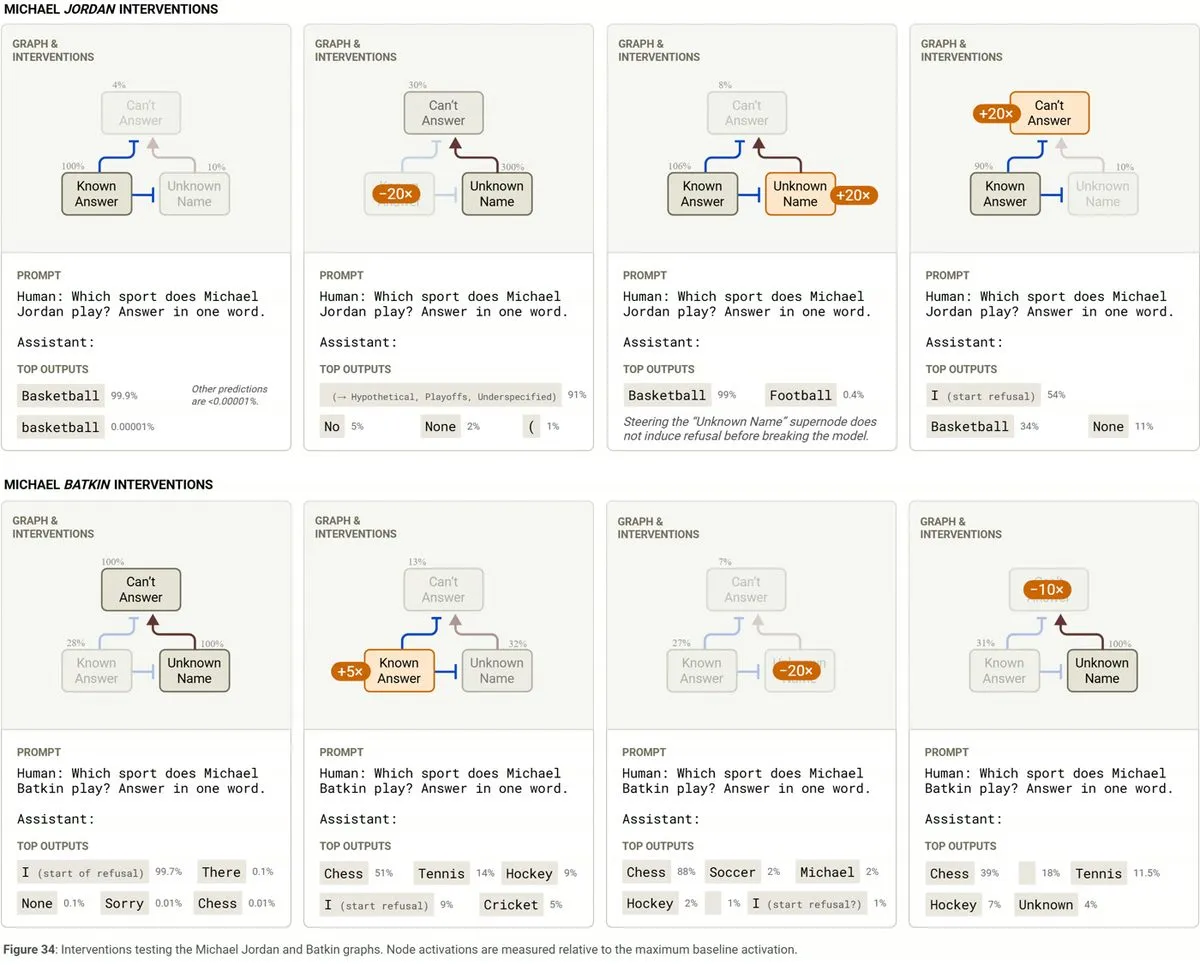
מתוך המאמר המדעי של אנתרופיק: רשת ההתערבויות. כל פאנל מראה מה קורה לתשובה כשמזיזים את המתג הפנימי.
שני מקרים אמיתיים ששווה להכיר
1. המאמר שלא קיים
החוקרים שאלו את המודל על ג’וש בטסון, חוקר אמיתי אבל לא מפורסם (במקרה, אחד המחברים של המחקר עצמו). כשהגבירו את מנגנון הזיהוי פי 15, המודל המציא בביטחון מלא מאמר בשם “עקרון בטסון” והוסיף לו גם נושא: חשיבות קבלת החלטות אתית בעסקים.
המאמר הזה לא קיים. הוא הומצא מאפס, כולל הכותרת והתקציר, רק כי אות הביטחון הפנימי הועלה.
2. המקרה שקרה מעצמו
המקרה השני חשוב יותר, כי הוא לא דרש שום התערבות. שאלו את המודל לנקוב בשם מאמר של אנדריי קרפתי, מהחוקרים המוכרים בעולם. המודל ענה בביטחון שהוא כתב את ImageNet Classification with Deep Convolutional Neural Networks. הוא לא כתב אותו.
זו התבנית שכדאי לחרוט: המודל מכיר מצוין את קרפתי, אבל לא מכיר את רשימת המאמרים שלו. זיהוי השם הספיק כדי לשחרר את הבלם, והחור התמלא במאמר הכי סביר בתחום.
אזור הסכנה שלך: ישות מפורסמת בשילוב פרט ספציפי ואזוטרי. דווקא שאלה על מישהו אלמוני לגמרי בטוחה יותר, כי שם הסירוב עובד כמו שצריך.
הפרומפט המדויק
עכשיו מובן למה התיקון עובד. כשאתה נותן למודל רשות מפורשת להגיד “אני לא בטוח”, אתה לא מלמד אותו שום דבר חדש. אתה מחזיר לפעולה מנגנון שכבר קיים בו וכובה בטעות.
זה הנוסח. הדבק אותו בתחילת השיחה או בהוראות המערכת:
אם אתה לא יודע, או אם החומר שסיפקתי לא מכיל את התשובה,
תענה בדיוק: “אין לי מספיק מידע כדי לענות על זה”.
אל תנחש. “אני לא יודע” זו תשובה נכונה ומקובלת כאן.
אני מעדיף שתגיד שאתה לא בטוח מאשר שתנחש בביטחון.
הגרסה הרשמית באנגלית, מתוך התיעוד של אנתרופיק:
If you're unsure about any aspect or if the report lacks necessary
information, say "I don't have enough information to confidently
assess this."
שלושת ההרגלים
פרומפט אחד זה התחלה. מה שבאמת מוריד את שיעור ההזיות הוא שינוי בדרך העבודה. שלושה הרגלים, לפי סדר החשיבות:
הרגל 1: אל תשאל על ישות, הדבק את הישות
ברגע שהעובדה נמצאת בתוך השיחה, המודל לא מתייעץ בכלל עם האות הפנימי של “אני מכיר את זה”. המנגנון שגורם להזיה פשוט לא רלוונטי. הכלל הפשוט: ככל שהנושא נדיר או טרי יותר, כך התשובה חייבת לבוא מטקסט שהדבקת, לא מהזיכרון של המודל.
כדי לחדד את זה, הוסף את ההוראה:
תתבסס אך ורק על המסמכים שסיפקתי. אל תשתמש בידע כללי שלך.
הרגל 2: ציטוטים לפני מסקנות, תמיד בסדר הזה
שני תורים נפרדים, אף פעם לא אחד. בתור הראשון מבקשים חילוץ, ורק בתור השני מסקנות. זו ההמלצה הרשמית של אנתרופיק למסמכים ארוכים, והיא עובדת כי ציטוט אפשר לבדוק מול המקור בשתי שניות, ומסקנה אי אפשר.
יש לזה בונוס: אם התור הראשון חוזר עם “לא נמצאו ציטוטים רלוונטיים”, גילית שהתשובה לא קיימת בחומר שלך, בדיוק המידע שהזיה הייתה מסתירה ממך.
1. קודם כול, חלץ ציטוטים מדויקים מילה במילה מהמסמך שרלוונטיים לשאלה,
ומספר אותם [1], [2], [3]. אם אין: כתוב “לא נמצאו ציטוטים רלוונטיים”.
2. רק אחר כך תענה, על סמך הציטוטים הממוספרים בלבד, כשאתה מפנה לכל
טענה למספר הציטוט שלה.
הרגל 3: תפריד בין מי שכותב לבין מי שבודק
המודל שכתב את התשובה הוא הבודק הגרוע ביותר שלה, כי הוא כבר התחייב למסגור. פתח צ’אט חדש, הדבק את התשובה כאילו מישהו אחר כתב אותה, ובקש ביקורת:
למטה תשובה שהופקה על ידי מודל אחר. אל תגן עליה ואל תשפר את הניסוח.
לכל טענה עובדתית סמן: “מאומת”, “ללא תימוכין” או “שגוי”, וציין מול מה בדקת.
פרט בנפרד כל שם, מספר, תאריך, כותרת וציטוט, אלה הפריטים המסוכנים.
סיים בשאלה: איזו טענה כאן הכי סבירה שהיא מומצאת, ולמה?
גרסה זולה של אותו רעיון: שאל את אותה שאלה עובדתית שלוש פעמים בשלושה צ’אטים נקיים. עובדה שהמודל באמת יודע חוזרת זהה בכל פעם. תשובה שמשתנה בין הרצות היא טביעת אצבע של הזיה.
פרומפט בונוס: שלושה בלוקים
הכישלון במקרה של קרפתי היה שהמודל אף פעם לא הפיק בלוק של “לא ידוע”. הוא קיפל את “אני מזהה את השם” לתוך “אני יודע את העובדה”. הפרומפט הזה מכריח אותו להוציא את ההבחנה החוצה:
תענה בשלושה בלוקים נפרדים:
[מאומת]: עובדות שאתה בטוח בהן, עם מקור או ציטוט לכל אחת.
[לא בטוח]: דברים שאתה מעריך אבל לא יכול לגבות. תסביר למה.
[לא ידוע]: מה היה חסר לך כדי לענות כמו שצריך.
אל תעביר פריט מ”לא ידוע” ל”מאומת” רק כדי שהתשובה תיראה שלמה.
מה זה לא פותר
חשוב להיות מדויקים: הטכניקות האלה מורידות את שיעור ההזיות. הן לא מבטלות אותו. אנתרופיק כותבים את זה במפורש בתיעוד שלהם, ומחקר קליני שבדק 5,400 תשובות מצא ירידה מ-66 אחוז ל-44 אחוז בעקבות פרומפט מיטיגציה, שיפור אמיתי, ועדיין רחוק מאפס. אצל המודל הטוב בניסוי הירידה הייתה מ-53 אחוז ל-23 אחוז.
- טמפרטורה היא לא הפתרון. באותו מחקר, הרצה בטמפרטורה 0 נתנה 66.5 אחוז, כלומר בלי שינוי מובהק. תשכח מהעצה הזו.
- הצמדה למקורות לא מסירה את הסיכון, היא מזיזה אותו. אם הטקסט שהדבקת שגוי, המודל יהיה נאמן לשגיאה.
- גם ציטוטים אפשר להמציא. המקרה של קרפתי הוא בדיוק זה: כותרת אמיתית, שיוך שגוי. תפתח את הלינקים.
- יש חלק שהוא מתמטית בלתי נמנע. עובדה שהופיעה פעם אחת בלבד באימון, או בכלל לא הופיעה, לא תישלף בשום פרומפט.
- אל תפעיל את זה על סיעור מוחות. פרומפטים של חילוץ ואימות מדכאים יצירתיות. תפעיל אותם על כל דבר שיש בו שם, מספר, תאריך או ציטוט.
והערה על המחקר עצמו: הממצאים הם ממודל אחד (Claude 3.5 Haiku) ובשיטה אחת, והחוקרים אומרים בעצמם שמה שזוהה מסביר רק חלק מהתמונה. זו התמונה המכניסטית הכי טובה שיש לנו היום, לא מדע סגור.
סיכום בשורה אחת
המודל לא נכשל בלדעת. הוא נכשל בלדעת שהוא לא יודע. כל טכניקה במדריך הזה היא דרך אחת להפוך את ההערכה העצמית הזו לפלט מפורש שאפשר לבדוק, במקום החלטה פנימית שקטה שאתה לא רואה.
ואגב, אנתרופיק השתמשו בדיוק בממצא הזה כדי לאמן את הדור הבא של המודלים לענות בכנות רבה יותר.
לינקים
- המחקר המקורי של אנתרופיק: Tracing the thoughts of a large language model
- המאמר המדעי המלא, פרק ההזיות: On the Biology of a Large Language Model
- התיעוד הרשמי של אנתרופיק להפחתת הזיות: Reduce hallucinations
- למה מודלים מזים, מחקר של OpenAI: Why Language Models Hallucinate
- המחקר הקליני עם המספרים: Communications Medicine 2025
