מה זה GLM-5.3
GLM-5.3 הוא מודל שפה של החברה הסינית Z.AI, שיצא ב-14 באוגוסט 2026. הוא נבנה בעיקר לקוד ולעבודה של סוכנים, כלומר לא רק לכתוב לכם פונקציה, אלא לקבל טרמינל אמיתי ומשימה שלמה ולסיים אותה לבד.
הדבר המעניין בו הוא לא הביצועים בקוד אלא מה שקרה בדרך: תוך כדי האימון התפתחה לו יכולת שהחברה עצמה לא ציפתה לה, זיהוי חולשות אבטחה בקוד אמיתי. הם הריצו אותו עם צוותי אבטחה על פרויקטי קוד פתוח, והתוצאה לטענתם היא 2,436 חולשות ב-269 פרויקטים, מתוכן 1,097 בדרגת חומרה בינונית עד גבוהה. חלק מהבאגים ישבו שם שנים, הישן ביותר הוכנס לקוד ב-1981.
ובניגוד ל-Claude או ל-GPT, אתם לא חייבים להיות תלויים רק ב-API של החברה. Z.AI שחררו את המשקולות של המודל, כך שאפשר להוריד אותו ולהריץ על תשתית שלכם. השאלה היא רק מה זה דורש בפועל, וזה בדיוק מה שהמדריך הזה עונה עליו.
ההבדל בין GLM-5.3 ל-GLM-5.3-Flash
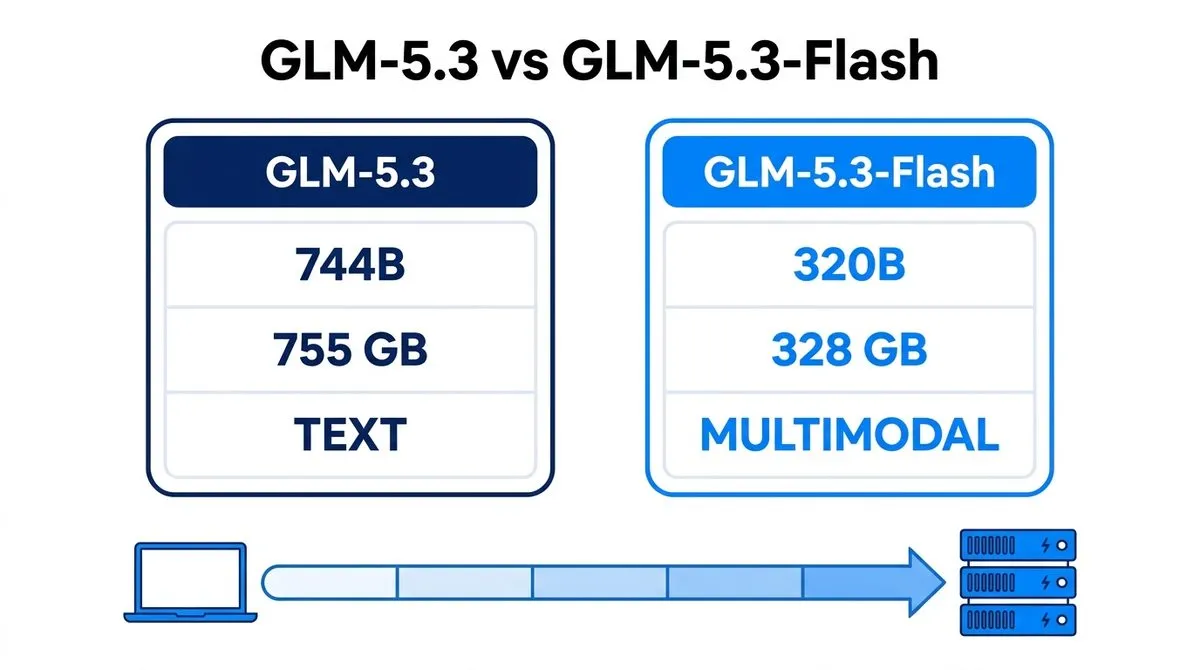
יש שתי גרסאות, והבלבול ביניהן הוא הדבר הכי נפוץ. Flash היא לא סתם “גרסה קטנה”, היא מודל אחר, עם רישיון אחר ויכולות אחרות:
| מאפיין | GLM-5.3 | GLM-5.3-Flash |
|---|---|---|
| פרמטרים | 744B סה”כ / 40B פעילים | 320B סה”כ / 18B פעילים |
| קלט | טקסט בלבד | טקסט, תמונה ווידאו |
| חלון הקשר | מיליון טוקנים | מיליון טוקנים |
| משקולות FP8 | 755 ג’יגה, 141 קבצים | 328 ג’יגה, 62 קבצים |
| משקולות BF16 | כ-1.5 טרה | 643 ג’יגה |
| רישיון | רישיון מותאם של Z.AI | MIT: מסחרי חופשי |
שתי נקודות שכדאי לשים לב אליהן. ראשית, Flash היא המולטימודאלית מבין השתיים, היא מקבלת תמונות ווידאו, והגדולה לא. שנית, Flash היא ברישיון MIT נקי, בעוד שלגרסה המלאה יש רישיון מותאם עם סעיף שמחייב בדיקת אבטחה של Z.AI מעל רף הכנסות של 10 מיליארד דולר. לרובנו הרף הזה לא רלוונטי, אבל MIT פשוט אומר שאין מה לקרוא.
הביצועים: מה המספרים אומרים
שני מבחנים מסבירים למה הדגם הזה קיבל תשומת לב:
| מבחן | GLM-5.2 | GLM-5.3 | הסגורים |
|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | 33.7 / 34.6 |
| CyberGym | 77.2 | 84.5 | 83.8 / 83.6 |
ב-Terminal Bench 3.0 נותנים לסוכן טרמינל אמיתי ומשימות שהוא צריך לסיים לבד. הקפיצה מ-4.6 ל-28.3 בין גרסה לגרסה היא חריגה, אבל המודלים הסגורים עדיין לפניו.
ב-CyberGym, שבודק זיהוי חולשות בקוד אמיתי, הוא דווקא עובר אותם. זו הפעם הראשונה שמודל בעל משקולות פתוחות מוביל במבחן אבטחה מול הסגורים, וזו הסיבה ש-Z.AI עיכבו את שחרור המשקולות בשבועיים כדי לעשות הערכת בטיחות.
איך מורידים את המודל
שלב 1: התקינו את כלי ההורדה של Hugging Face:
pip install -U "huggingface_hub[cli]"שלב 2: בדקו כמה מקום זה תופס לפני שאתם מתחייבים לדיסק:
hf download zai-org/GLM-5.3-Flash --dry-runשלב 3: הורידו:
hf download zai-org/GLM-5.3-Flash --local-dir ./GLM-5.3-Flashאם Hugging Face מגבילים לכם את קצב ההורדה, יש מראה זהה ב-ModelScope תחת השם ZhipuAI/GLM-5.3-Flash.
איך מריצים אותו
vLLM: הדרך הרשמית
זו הדרך שמתועדת רשמית, ודורשת vLLM בגרסה 0.28.0 ומעלה:
vllm serve zai-org/GLM-5.3-Flash \
  --tensor-parallel-size 4 \
  --kv-cache-dtype fp8 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --enable-auto-tool-choice
שני הפרשנים בסוף חשובים: בלעדיהם קריאות הכלים והחשיבה של המודל יחזרו כטקסט גולמי במקום כשדות מובנים.
SGLang
python3 -m sglang.launch_server --model-path zai-org/GLM-5.3-FlashGGUF: למי שאין חוות שרתים
הגרסאות המכווצות הן הדרך הריאלית היחידה להריץ מקומית. עבור Flash:
ollama run hf.co/AtomicChat/GLM-5.3-Flash-GGUF:Q4_K_Mהכלל הוא לבחור את הקובץ הגדול ביותר שנכנס לזיכרון שלכם עם מקום שיישאר להקשר. Q4_K_M הוא ברירת המחדל המומלצת, ו-IQ3_M היא הבחירה הטובה ביותר כשהזיכרון צר.
איזו חומרה באמת צריך
כאן נמצא ה”קאץ’” הגדול. משקולות פתוחות זה רישיון והורדה, לא לפטופ.
| מה מריצים | מה צריך | הערה |
|---|---|---|
| Flash ב-FP8 | כ-386 ג’יגה VRAM, שמונה כרטיסי H100 | נקודת הכניסה המעשית |
| GLM-5.3 מלא ב-FP8 | שמונה כרטיסי H200 או H20, 141 ג’יגה כל אחד | צומת אחד שלם |
| מיליון טוקנים מלאים | שמונה כרטיסי B200, 180 ג’יגה כל אחד | עם KV cache ב-FP8 |
| BF16 | פריסה על כמה צמתים | שתי הגרסאות |
| GGUF מכווץ | תלוי ברמת הכיווץ שבחרתם | הדרך המקומית הריאלית |
וכדי לסגור את הוויכוח על “אני אכווץ את זה ויהיה בסדר”: אפילו הכיווץ האגרסיבי ביותר של הגרסה המלאה, ברמת ביט אחד, שוקל 217 ג’יגה. ברמת 4 ביט זה כבר 467 ג’יגה. מחשב גיימינג או מק רגיל הם לא בית ריאלי לצ’קפוינט הרשמי של אף אחת משתי הגרסאות.
אם אין לכם את החומרה, האפשרות השלישית
אפשר פשוט להשתמש ב-API של Z.AI. הוא תואם ל-OpenAI, כך שאם כבר יש לכם קוד שעובד מול OpenAI, כל מה שצריך זה להחליף את כתובת הבסיס ואת המפתח:
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["ZAI_API_KEY"],
    base_url="https://api.z.ai/api/paas/v4/",
)

response = client.chat.completions.create(
    model="glm-5.3",
    messages=[{"role": "user", "content": "..."}],
    extra_body={"reasoning_effort": "high"},
)
התמחור שפורסם הוא 1.40 דולר למיליון טוקני קלט, 0.26 דולר לקלט מטמון, ו-4.40 דולר למיליון טוקני פלט. הפרמטר reasoning_effort מקבל low, high או max ומאפשר לכם לסחור בין עלות לאיכות.
טיפים
- אם אתם מתלבטים בין הגרסאות, קחו את Flash. היא מולטימודאלית, ברישיון MIT, ושוקלת פחות מחצי מהגדולה.
- הריצו dry-run לפני כל הורדה. 328 ג’יגה זה לא משהו שמגלים באמצע.
- אל תשכחו את tool-call-parser ו-reasoning-parser ב-vLLM, אחרת קריאות הכלים יחזרו כטקסט.
- לניסוי ראשוני, ה-API זול בהרבה משכירת שמונה כרטיסי H100 לשעה.
- בחרו GGUF לפי הזיכרון שיש לכם פחות מקום להקשר, לא לפי הגודל שנשמע לכם מרשים.
- המספרים של 2,436 החולשות הם טענה של Z.AI עצמם. הם מתעדים אותן ביומן חשיפות פומבי, אבל שווה לזכור שזו בדיקה עצמית.
- יש גם AMD: Instinct gfx950 דרך ROCm, עם ה-backend של ROCM_AITER_MLA_SPARSE.
לינקים
- ההכרזה הרשמית: z.ai/blog/glm-5.3
- המשקולות של Flash: huggingface.co/zai-org/GLM-5.3-Flash
- המשקולות של הגרסה המלאה: huggingface.co/zai-org/GLM-5.3
- מתכון ההרצה הרשמי ב-vLLM: recipes.vllm.ai/zai-org/GLM-5.3-Flash
- התיעוד למפתחים: docs.z.ai/guides/llm/glm-5.3
- הריפו ב-GitHub: github.com/zai-org/GLM-5
