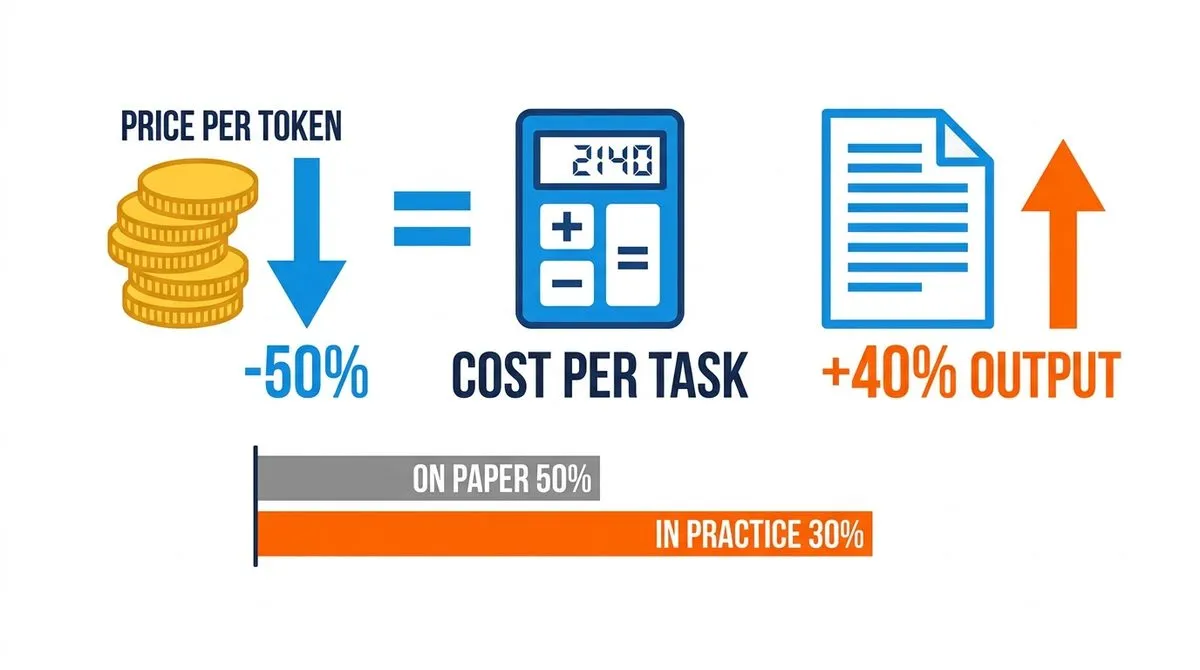
הבעיה: הורידו לכם את המחיר, והחשבון עלה
באוגוסט 2026 גוגל השיקה את Gemini 3.7 Flash והכריזה על חצי מחיר. המחירון באמת ירד בחצי. ובכל זאת, אצל חלק מהמשתמשים החשבון החודשי דווקא עלה.
זו לא טעות בחיוב. זה פער בין שתי יחידות מדידה שונות: אתם מסתכלים על מחיר לטוקן, אבל מה שאתם באמת קונים זה משימות.
המדריך הזה נותן לכם את הנוסחה, את הקוד למדידה, ואת החישוב המלא, כדי שתדעו בדיוק כמה עולה לכם משימה אחת, בכל מודל.
טוקן מול משימה: ההבדל שעולה כסף
טוקן הוא בערך חתיכה של מילה. בעברית ובאנגלית מילה ממוצעת מתפרקת ל-2 עד 4 טוקנים. כל ספקי ה-AI מחייבים לפי טוקנים: כמה נכנס למודל (input) וכמה יצא ממנו (output).
אבל אתם לא מודדים את העבודה שלכם בטוקנים. אתם מודדים אותה במשימות: לתקן באג, לסכם מסמך, לענות ללקוח, לכתוב פיצ’ר.
והנה הנקודה: המחיר לטוקן והכמות שהמודל מייצר הם שני משתנים נפרדים. ספק יכול להוריד את הראשון, ובמקביל המודל החדש יצרוך יותר מהשני. התוצאה, חיסכון על הנייר, ואפילו התייקרות בפועל.
למה מודלים חדשים מייצרים יותר טקסט
- מודלי חשיבה (reasoning) מייצרים טוקנים פנימיים של חשיבה לפני התשובה, ואתם משלמים גם עליהם
- ככל שרמת החשיבה גבוהה יותר, כך צריכת הטוקנים גדלה, לפעמים פי כמה
- מודלים אגנטיים מריצים כמה סבבים של כלים לכל משימה, וכל סבב הוא עוד input ועוד output
- שיפור ביכולות מגיע לרוב עם יותר מילים, לא עם פחות
מקרה מבחן: Gemini 3.7 Flash
Gemini 3.7 Flash הוא מודל העבודה החדש של גוגל, מכוון לכתיבת קוד ולסוכנים שרצים ברקע. הוא באמת קפץ ביכולות: 65.3% ב-DeepSWE v1.1 לעומת 48.6% של Gemini 3.6 Flash, חלון הקשר של מיליון טוקנים ותקרת פלט של 64 אלף טוקנים.
וזה גם המקרה הכי נקי להדגים בו את הפער בין מחיר לטוקן לעלות למשימה. הנה שלוש המדרגות:
| מודל / תקופה | Input ל-1M | Output ל-1M | מתי |
|---|---|---|---|
| Gemini 3.6 Flash | $1.50 | $7.50 | הדור הקודם |
| Gemini 3.7 Flash: מחיר היכרות | $0.75 | $3.75 | עד 31.12.2026 |
| Gemini 3.7 Flash: מחירון מלא | $1.50 | $7.50 | החל מ-1.1.2027 |
שימו לב לשורה האחרונה: ב-1 בינואר 2027 התעריף חוזר בדיוק לתעריף של הדור הקודם. זו לא הנחה שנגמרת, זו חזרה לנקודת ההתחלה.
הממצא שמשנה את התמונה
Artificial Analysis, שמודדים מודלים באופן עצמאי, מצאו ש-Gemini 3.7 Flash ברמת חשיבה גבוהה צורך בערך 40% יותר טוקני פלט מ-3.6 Flash, ממוצע של כ-37,000 טוקני פלט למשימה.
כלומר: המחיר ליחידה ירד בחצי, אבל מספר היחידות למשימה עלה ב-40%.
הנוסחה: עלות למשימה
זו כל התורה על רגל אחת. ארבעה מספרים, פעולה אחת:
cost_per_task = (input_tokens / 1e6) * price_in
              + (output_tokens / 1e6) * price_out
input_tokens ו-output_tokens הם ממוצע אמיתי מהמדידות שלכם, לא הערכה. price_in ו-price_out הם המחיר למיליון טוקנים מהמחירון של הספק.
החוק הפשוט: אף פעם אל תשוו מחירונים. תשוו עלות למשימה.
החישוב המלא: צעד אחרי צעד
נניח משימת קוד טיפוסית: 10,000 טוקני קלט (הפרומפט, הקבצים, ההקשר). לפי המדידה של Artificial Analysis, 3.7 Flash מייצר כ-37,000 טוקני פלט למשימה כזו, ו-3.6 Flash מייצר כ-40% פחות, כלומר כ-26,400.
שלב 1: המודל הקודם, Gemini 3.6 Flash
input:   10,000 / 1,000,000 * $1.50 = $0.0150
output:  26,400 / 1,000,000 * $7.50 = $0.1980
--------------------------------------------
cost per task                       = $0.2130
שלב 2: Gemini 3.7 Flash במחיר ההיכרות
input:   10,000 / 1,000,000 * $0.75 = $0.0075
output:  37,000 / 1,000,000 * $3.75 = $0.1388
--------------------------------------------
cost per task                       = $0.1463
החיסכון האמיתי: 31% ולא 50%. המחירון ירד בחצי, אבל ה-40% טוקנים הנוספים אכלו כמעט 20 נקודות אחוז מהחיסכון.
שלב 3: Gemini 3.7 Flash מ-1 בינואר 2027
input:   10,000 / 1,000,000 * $1.50 = $0.0150
output:  37,000 / 1,000,000 * $7.50 = $0.2775
--------------------------------------------
cost per task                       = $0.2925
אותה משימה בדיוק תעלה 37% יותר מאשר במודל הקודם. לא הנחה שנגמרת: התייקרות שנכנסת מהדלת האחורית.
| תרחיש | טוקני פלט | עלות למשימה | מול 3.6 Flash |
|---|---|---|---|
| 3.6 Flash (בסיס) | 26,400 | $0.2130 | - |
| 3.7 Flash: מחיר היכרות | 37,000 | $0.1463 | 31% חיסכון |
| 3.7 Flash: מ-1.1.2027 | 37,000 | $0.2925 | 37% התייקרות |
המספרים מבוססים על 10,000 טוקני קלט למשימה. שנו את המספר הזה לפי המדידה שלכם, היחס בין השורות כמעט לא ישתנה, כי רוב העלות יושבת על הפלט.
איך מודדים את זה אצלכם, בקוד
אל תנחשו את מספר הטוקנים. כל ספק מחזיר אותו בתשובה של ה-API. שלוש דוגמאות:
Gemini API (Python)
from google import genai

client = genai.Client()
resp = client.models.generate_content(
    model="gemini-3.7-flash",
    contents="summarize this ticket ...",
)

u = resp.usage_metadata
print(u.prompt_token_count)      # input
print(u.candidates_token_count)  # output
print(u.thoughts_token_count)    # reasoning tokens - you pay for these too
print(u.total_token_count)
Anthropic API (Python)
import anthropic

client = anthropic.Anthropic()
msg = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "..."}],
)

print(msg.usage.input_tokens, msg.usage.output_tokens)
מחשבון עלות למשימה (JavaScript)
const PRICES = {
  "gemini-3.6-flash":          { in: 1.50, out: 7.50 },
  "gemini-3.7-flash-intro":    { in: 0.75, out: 3.75 },
  "gemini-3.7-flash-2027":     { in: 1.50, out: 7.50 },
};

function costPerTask(model, inTokens, outTokens) {
  const p = PRICES[model];
  return (inTokens / 1e6) * p.in + (outTokens / 1e6) * p.out;
}

// average over your last N real runs, never a single sample
function avgCost(model, runs) {
  const total = runs.reduce(
    (s, r) => s + costPerTask(model, r.inTokens, r.outTokens), 0);
  return total / runs.length;
}
שמרו את שני המספרים האלה בלוג לכל קריאה. תוך שבוע יהיה לכם ממוצע אמיתי, ותוכלו להשוות מודלים על נתונים במקום על מחירונים.
שבעה טיפים להוזלת העלות למשימה
- מדדו לפני שמחליפים מודל. הריצו 20 עד 50 משימות אמיתיות בכל מודל וחשבו ממוצע, לא דוגמה אחת
- הורידו את רמת החשיבה. ברוב המשימות low נותן את אותה תוצאה כמו high בשליש מהטוקנים
- הגבילו את הפלט. max_output_tokens ובקשה מפורשת לתשובה קצרה חוסכים ישירות בשורה היקרה
- השתמשו ב-prompt caching. הקשר קבוע שחוזר בכל קריאה עולה הרבה פחות כשהוא במטמון
- נתבו לפי סוג משימה. סיווג ותיוג לא צריכים את המודל החזק, שמרו אותו לקוד ולניתוח
- נקו את הקלט. הקשר מיותר לא רק עולה כסף בקלט, הוא גם גורם למודל לייצר פלט ארוך יותר
- שימו תזכורת ליומן לפני תום מחיר ההיכרות. חשבו מחדש את העלות למשימה לפני שהתעריף קופץ
דברים לשים לב אליהם
- טוקני חשיבה נספרים כפלט. במודלי reasoning זה יכול להיות רוב החשבון, גם אם התשובה הסופית קצרה
- מחיר היכרות הוא זמני מטבעו. אל תבנו תמחור מוצר על תעריף עם תאריך תפוגה
- ב-Gemini 3.7 Flash בוטלה רמת החשיבה minimal, ו-low הפכה למינימום. למשימות סיווג בנפח גבוה זה מייקר
- בדיקות עצמאיות מצאו ב-3.7 Flash שיעור הזיות של 64.5% לעומת 55.6% ב-3.6 Flash. דיוק עלה, אבל גם ההזיות
- מודלים אגנטיים מריצים כמה סבבים למשימה. מדדו את המשימה השלמה, לא קריאה בודדת
לינקים
- ההכרזה הרשמית של גוגל: blog.google, Introducing Gemini 3.7 Flash
- מדידות עצמאיות: Artificial Analysis, Gemini 3.7 Flash
- כרטיס המודל: DeepMind, Gemini 3.7 Flash Model Card
- תיעוד ה-API והמחירון: ai.google.dev, Gemini API
