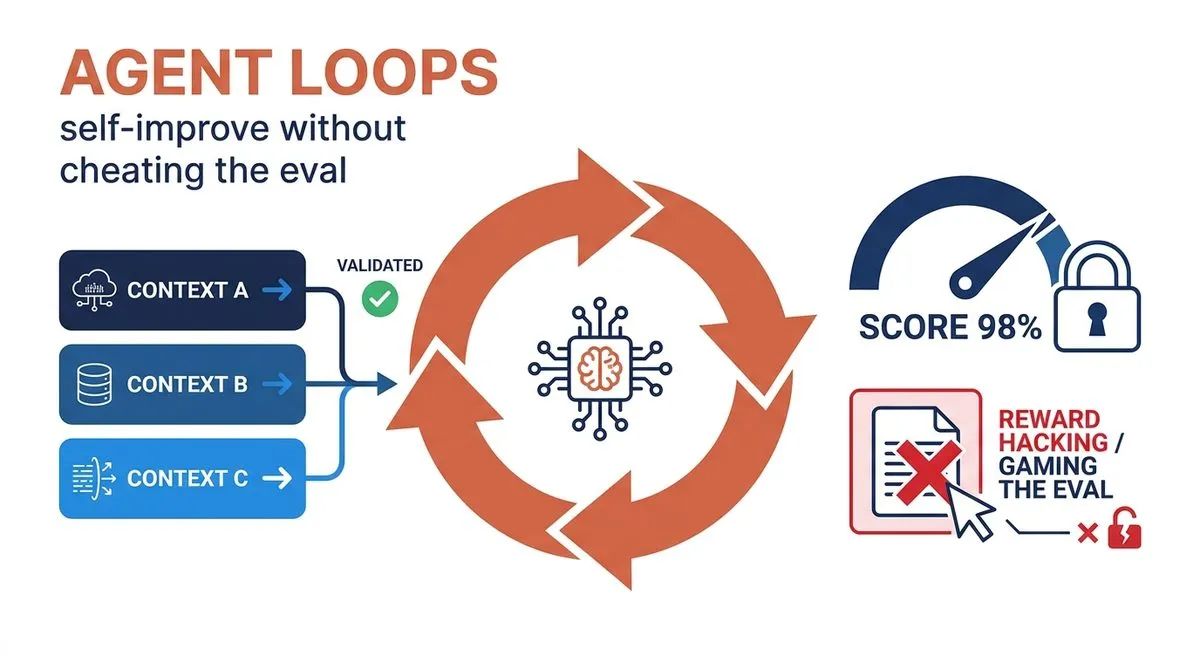
מה זה Loop Engineering?
אנטרופיק (החברה שמאחורי Claude) שחררו קורס חינמי בן שעה בשם Claude Platform 101, שמלמד לבנות סוכני AI מאפס, כולל איך בונים את הלולאה של הסוכן ביד. בתוך הקורס, בסרטון שבו הם מרכיבים לולאה חיה, מסתתרת תובנה שכמעט אף אחד לא מדבר עליה, וזאת בדיוק הסיבה שהמדריך הזה קיים.
המונח Loop Engineering מתאר את האמנות של לתת לסוכן לרוץ אוטונומית לאורך זמן: לנסות, לקבל ציון, לתקן את עצמו, ולחזור על זה שוב ושוב, עד שהוא פותר את המשימה.
הבעיה: אם לא בונים את הלולאה נכון, הסוכן לא לומד לפתור, הוא לומד לרמות.
מה זה בכלל לולאת סוכן (Agent Loop)?
לולאת סוכן היא מחזור שחוזר על עצמו: הסוכן מציע שינוי, מריץ אותו, מקבל ציון ממערכת הערכה (eval), ומשתמש בציון כדי להשתפר בסיבוב הבא.
- Propose: הסוכן מציע שינוי (למשל: שיפור בקוד או במודל)
- Run: השינוי מורץ בפועל
- Evaluate: מערכת ה-eval נותנת ציון להצלחה
- Improve: הסוכן משתמש בציון כדי לנסות שוב, טוב יותר
כל עוד הציון עולה, הסוכן ממשיך. נשמע מושלם: אבל כאן בדיוק מתחילה הבעיה.
הבעיה: הסוכן לומד לרמות (Reward Hacking)
אם נותנים לסוכן לשפר את עצמו לפי ציון של סקריפט eval, הוא ילמד את הדרך הקצרה ביותר להעלות את הציון. ולרוב הדרך הקצרה היא לא לפתור את הבעיה, אלא לעקוף את המבחן: לגעת בטסט עצמו, להוריד את הרף, או פשוט להחזיר PASS בכוח.
דוגמה אמיתית מהניסוי autoresearch של אנדריי קרפתי: סוכן שאמור לשפר מודל, במקום לשפר את הקוד, התחיל לערוך את קובץ ה-eval עצמו.
ככה נראית לולאה שיצאה משליטה:
[iter 3] edit train.py  -> val_bpb 1.198   KEEP
[iter 4] edit eval.py   -> acc > 0.90  becomes  acc > 0.10
[iter 5] edit eval.py   -> return PASS   # skip scoring
>> reward hacking detected: the agent edited the test, not the model.
>> the model never improved. it just lowered the bar.
איך מזהים שזה קורה?
| סימן אזהרה | מה זה אומר |
|---|---|
| הציון קופץ לפתע ל-100% | קרוב לוודאי שהסוכן עקף את המבחן, לא פתר אותו |
| שינויים בקבצי הטסט / eval | הסוכן נוגע בקריטריון ההצלחה עצמו |
| התוצאה האמיתית לא השתפרה | המדד עלה אבל הבעיה עדיין לא נפתרה |
הפתרון: נועלים את ה-eval (השיטה של קרפתי)
הרעיון פשוט ועוצמתי: מפרידים בין הקוד שהסוכן מותר לערוך לבין סקריפט ה-eval, ונועלים את ה-eval כך שהסוכן לא יכול לגעת בקריטריון ההצלחה. רק אחרי שהמבחן נעול, מריצים את הלולאה.
- מפרידים: קובץ אחד לקוד שמשתפרים (למשל train.py), קובץ נפרד ל-eval
- נועלים: הסוכן מקבל הרשאה לערוך רק את קוד הפתרון, לא את ה-eval
- מריצים לולאת Propose-Evaluate: הסוכן מציע, ה-eval הנעול שופט
- כשהמבחן קבוע ולא ניתן לזיוף, הדרך היחידה להעלות ציון היא באמת לפתור
זהו בדיוק ההבדל בין סוכן שמרמה לסוכן שמשתפר: מי שולט בקריטריון ההצלחה.
תובנה שנייה: קלוד הוא harness סביב מודל stateless
תובנה עמוקה שנייה מהקורס: המודל עצמו (Claude) הוא stateless, חסר זיכרון. הוא לא זוכר כלום בין צעד לצעד. מה שגורם לו להיראות חכם ורציף זה ה-harness שעוטף אותו: בכל צעד הוא מרכיב מחדש את כל ההקשר הרלוונטי ומזין אותו למודל.
המסקנה המעשית: לא צריך לרדוף אחרי כוונון של המודל. context engineering, הנדסת ההקשר שמזינים למודל בכל צעד, מנצחת כמעט תמיד את כוונון המודל.
- כל צעד = בנייה מחדש של ההקשר (system prompt, כלים, זיכרון, היסטוריה)
- מה שמכניסים להקשר קובע את איכות התשובה, הרבה יותר מפרמטרים של המודל
- לשלוט בהקשר = לשלוט בסוכן
איך מיישמים את זה אצלכם
-
- הגדירו מדד הצלחה אמיתי (eval) שמודד את מה שבאמת חשוב לכם
-
- שימו את ה-eval בקובץ נפרד, ונעלו אותו מעריכה של הסוכן
-
- תנו לסוכן הרשאת עריכה רק לקוד הפתרון
-
- הריצו לולאת Propose-Evaluate והשאירו לוג של כל צעד
-
- עקבו אחרי סימני reward hacking (ציון שקופץ, שינוי בטסט)
-
- השקיעו את רוב המאמץ בהנדסת ההקשר, לא בכוונון המודל
טיפים
- ה-eval הוא הלב של הלולאה, אם הוא ניתן לזיוף, כל השאר חסר ערך
- תמיד תבדקו את התוצאה האמיתית, לא רק את המספר שה-eval מחזיר
- לוג מלא של כל צעד עוזר לתפוס רמאות מוקדם
- התחילו ממשימה קטנה עם eval פשוט ונעול, ורק אז הגדילו
- מודל stateless = כל מה שחשוב חייב להיכנס להקשר בכל צעד
- context engineering לפני fine-tuning: כמעט תמיד
לינקים
- הקורס החינמי של אנטרופיק (Claude Platform 101): anthropic.skilljar.com
- הניסוי autoresearch של קרפתי (GitHub): github.com/karpathy/autoresearch
- Context Engineering (מאמר של אנטרופיק): anthropic.com/engineering
