מה זה Zero Data Retention
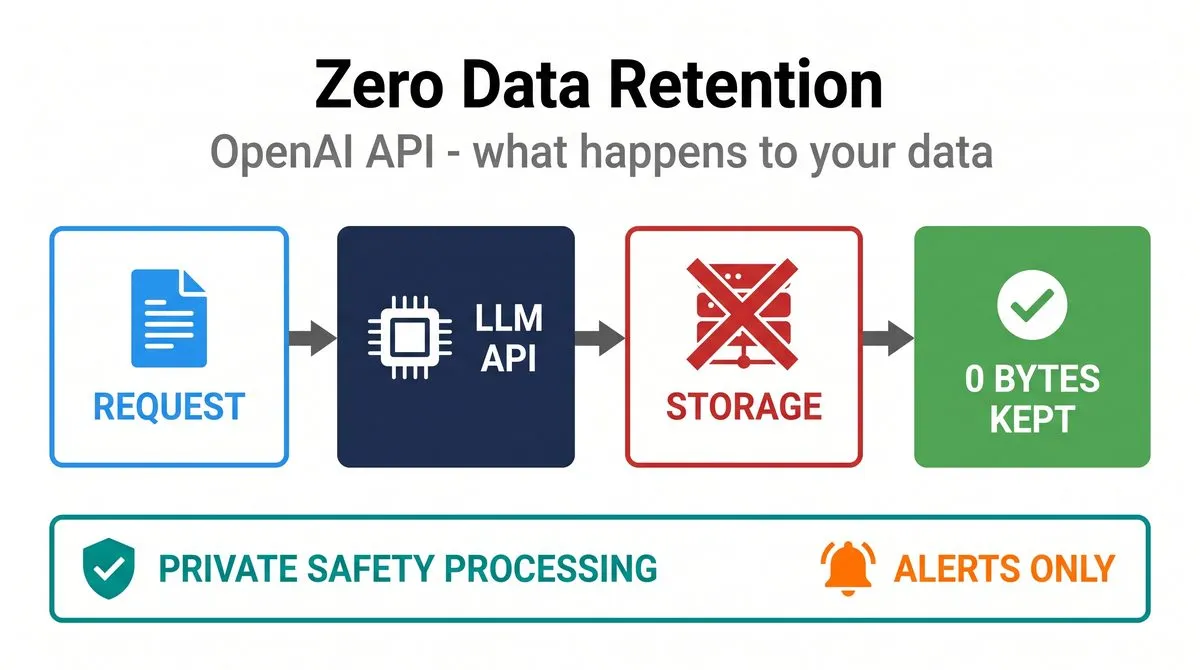
Zero Data Retention (בקיצור ZDR) הוא מצב הפעלה של ה-API של OpenAI שבו התוכן של הבקשות שלכם לא נשמר בשום מקום אחרי שהתשובה חוזרת. לא הפרומפט, ולא התשובה של המודל.
ההבטחה מנוסחת בשלושה חלקים: התוכן לא נשמר אחרי העיבוד, אף עובד של OpenAI לא יכול לגשת אליו לצורך בדיקה, והמידע של לקוחות ארגוניים לא משמש לאימון המודלים אלא אם הלקוח בחר בכך מפורשות.
בברירת מחדל, בלי ZDR, OpenAI שומרת יומני ניטור שימוש לרעה (abuse monitoring logs) עד 30 יום. היומנים האלה יכולים להכיל תוכן של לקוחות, פרומפטים, תשובות, ומטא-דאטה שנגזר מהם. ZDR מוציא את התוכן שלכם מהיומנים האלה.
למה זה תוקע עסקאות
זה התרחיש שכל מי שמוכר מוצר AI לארגון גדול מכיר: בניתם כלי מעולה, הוא עובד מצוין, ואז מגיע לקוח רציני, בנק, קופת חולים, חברת ביטוח, גוף ממשלתי, ושואל שאלה אחת:
איפה יושב המידע שלנו?
ברגע שהתשובה היא שהתוכן נשמר אצל ספק ה-LLM, גם אם רק ל-30 יום ורק לצורך ניטור, אתם מתנגשים חזיתית בהתחייבויות האבטחה והרגולציה של הלקוח. בהרבה מקרים העסקה פשוט נעצרת שם.
ZDR הוא התשובה לשאלה הזאת. הוא הופך את המשפט הבעייתי ל-”התוכן לא נשמר בכלל”, וזה משפט שאפשר להביא לוועדת אבטחת מידע.
מה בדיוק לא נשמר: ומה כן
חשוב להבין ש-ZDR הוא לא “שום דבר לא נשמר אף פעם”. יש שלוש קטגוריות שכדאי להכיר:
| קטגוריה | מה קורה איתה תחת ZDR |
|---|---|
| תוכן הבקשה והתשובה | לא נשמר. לא לאימון, לא לגיבוי, ולא ליומני ניטור. אף עובד לא יכול לקרוא אותו. |
| Application State | כן נשמר זמנית: רק כדי לבצע את הבקשה עצמה. למשל פלט אודיו שנשמר לרגע לשיחה רב-תורית, מטמון פרומפטים (prompt cache), וכתיבה לדיסק בתוך קונטיינר. |
| חשד ל-CSAM | קבצים ותמונות שמסומנים כחשודים בתוכן פגיעה בקטינים נשמרים לבדיקה ידנית, גם תחת ZDR. זה חריג בטיחות שאין עליו ויתור. |
בנוסף, כשמפעילים ZDR הפרמטר store בקריאות ל-chat.completions ול-responses נכפה אוטומטית ל-false, לא משנה מה שולחים מהקוד:
{ "model": "gpt-5", "store": false, "messages": [...] }אילו endpoints נתמכים: ואילו לא
זו הנקודה שהכי מפילה אנשים בשלב האינטגרציה. ZDR לא חל על כל ה-API. אלה שמחזיקים מצב (state) בצד של OpenAI פשוט לא יכולים להיות ZDR:
| נתמך ב-ZDR | לא נתמך ב-ZDR |
|---|---|
/v1/chat/completions | /v1/conversations |
/v1/responses | /v1/assistants /v1/threads |
/v1/embeddings | /v1/vector_stores |
/v1/images/generations /edits | /v1/files |
/v1/audio/transcriptions /speech | /v1/fine_tuning/jobs |
/v1/moderations | /v1/batches /v1/evals |
/v1/realtime | /v1/videos /v1/chatkit/threads |
המשמעות המעשית: אם בניתם על Assistants API או על Vector Stores, מעבר ל-ZDR ידרוש ארכיטקטורה אחרת, להחזיק את ההיסטוריה והאחזור אצלכם ולשלוח ל-OpenAI רק את הבקשה עצמה.
הצד השני של המטבע: Private Safety Processing
ב-19 באוגוסט 2026 OpenAI פרסמה הכרזה שסוגרת בעיה אמיתית שנוצרה מ-ZDR עצמו.
הבעיה: ככל שסוכני AI עובדים לבד יותר זמן, סיכונים רציניים מתגלים רק כשמסתכלים על כמה אינטראקציות ביחד, שחקן שמנסה לשחוק את המגננות שוב ושוב, תיאום בין כמה חשבונות, או סוכן שממשיך לפעול אחרי שאמרו לו לעצור. מערכות הבטיחות הקיימות שתואמות ZDR בוחנות כל אינטראקציה בנפרד. וכשאין זיכרון, אין על מה להסתכל.
הפתרון שהוצג נקרא Private Safety Processing. הרעיון: לזהות דפוסים חשודים בין בקשות קשורות, בלי שאף עובד של OpenAI יקבל גישה לתוכן שמאחוריהן.
איך זה עובד בפועל
- התוכן נשאר על התשתית שהלקוח שולט בה. יש גם אופציה בפיתוח שבה התוכן יושב על התשתית של OpenAI אבל מוצפן במפתחות של הלקוח, ול-OpenAI אין עותק של המפתחות.
- מערכות אוטומטיות סורקות דפוסים על פני בקשות קשורות, לא רק על בקשה בודדת.
- כשמזוהה סיכון, OpenAI מקבלת אות מוגדר וצר שמציין את סוג הפעילות, לא את התוכן. גם כשמשהו מסומן, עובדי OpenAI לא מקבלים גישה לתוכן.
- הלקוח יכול לחקור את ההתראה במערכות שלו. אם הוא רוצה לערער או לתמוך בחקירה, הוא בוחר בעצמו לשתף מידע.
לוח זמנים: OpenAI מתכננת להתחיל להפעיל את Private Safety Processing ולפרסם מסמך טכני (white paper) בספטמבר 2026. נכון להכרזה, היכולת נבדקת עם לקוחות מוקדמים ומיועדת ללקוחות ארגוניים ו-API, לא למנויי ChatGPT הרגילים.
איך מקבלים ZDR
ZDR הוא לא מתג שמדליקים לבד בדשבורד. זה תהליך אישור:
- פונים לצוות המכירות של OpenAI ובודקים זכאות. ZDR ו-Modified Abuse Monitoring דורשים אישור מראש מ-OpenAI.
- חותמים על ההתחייבויות הנוספות שנלוות לזה.
- בוחרים בין Modified Abuse Monitoring לבין Zero Data Retention, האישור ניתן ברמת הארגון או ברמת הפרויקט ב-API.
- מתאימים את הארכיטקטורה כך שתשתמשו רק ב-endpoints הזכאים.
הבדל חשוב: Modified Abuse Monitoring מוציא את התוכן שלכם מהיומנים אבל מאפשר עדיין שמירה מסוימת לצורכי בטיחות. ZDR הוא המצב המחמיר יותר, בלי שמירה בכלל.
מה נשאר באחריות שלכם
זו הנקודה שהכי הרבה ארגונים מפספסים. ברגע שהפעלתם ZDR או Modified Abuse Monitoring, נטל האכיפה עובר אליכם:
- אתם אחראים לוודא שהמשתמשים שלכם עומדים במדיניות השימוש של OpenAI. אין מי שיתפוס בשבילכם שימוש לרעה.
- OpenAI שומרת לעצמה את הזכות לבטל זכאות ZDR עבור מודלים מסוימים אם עולות בעיות בטיחות.
- אם אין לכם לוגים משלכם, אין לכם מה להראות בחקירה. כדאי לבנות שכבת audit פנימית אצלכם עוד לפני שעוברים ל-ZDR.
- ZDR לא פוטר אתכם מ-GDPR, מחוק הגנת הפרטיות או מהתחייבויות מול הלקוח. הוא כלי שעוזר לעמוד בהן, לא תחליף להן.
טיפים
- לפני שמבטיחים ללקוח ZDR: בדקו איזה endpoints המוצר שלכם באמת משתמש בהם. Assistants ו-Vector Stores יפילו את זה.
- בנו את שכבת ההיסטוריה והאחזור (RAG) אצלכם. זה גם נכון ארכיטקטונית וגם מה שיאפשר ZDR.
- אל תסתמכו על store: false בקוד כמנגנון פרטיות. תחת ZDR זה נכפה ממילא, ובלי ZDR זה לא מונע את יומני הניטור.
- תעדו את סוג האישור שקיבלתם (ZDR מול Modified), ועדות אבטחת מידע שואלות בדיוק את זה.
- הוסיפו לוגים משלכם עם מדיניות שמירה מוגדרת. בלי זה אתם עיוורים לגמרי בדיוק במקום שבו הרגולטור מצפה שתראו.
- אם אתם מריצים סוכנים ארוכי טווח, עקבו אחרי Private Safety Processing. זה בדיוק המקרה שהוא נבנה בשבילו.
מגבלות שכדאי להכיר
- ZDR לא זמין לכולם: הוא דורש אישור מראש והוא מיועד ללקוחות API וארגוניים.
- מטמון פרומפטים ומצב אפליקציה עדיין קיימים זמנית. זה לא “אפס בתים” מוחלט.
- חריג ה-CSAM לא ניתן לביטול.
- Private Safety Processing עדיין בתצוגה מקדימה, ההפעלה מתחילה בספטמבר 2026.
לינקים
- ההכרזה הרשמית של OpenAI: Offering Zero Data Retention for frontier models
- התיעוד הרשמי: Data controls in the OpenAI platform: developers.openai.com/api/docs/guides/your-data
- מדיניות השימוש של OpenAI: openai.com/policies/usage-policies
