מה זה GPT-Live-1
כולם מכירים את הרגע: מדברים עם בוט קולי, משנים את השאלה באמצע, והוא ממשיך להקריא את אותו משפט כאילו לא אמרתם כלום. הבוטים הישנים עובדים בתורות: הם מקשיבים, ואז מדברים, ואז מקשיבים שוב. GPT-Live-1 מקשיב בזמן שהוא מדבר. אפשר לקטוע אותו, לשנות כיוון, והוא עוצר, מבין את השינוי וממשיך את השיחה בלי להתחיל הכול מחדש.
ב-10 בספטמבר 2026 OpenAI פתחה את המודל למפתחים דרך ה-API. עד אז הוא היה זמין רק בתוך ChatGPT. עכשיו אפשר לבנות עליו בוט תמיכה, בוט הזמנות או נציג מכירות שעונה לטלפון.
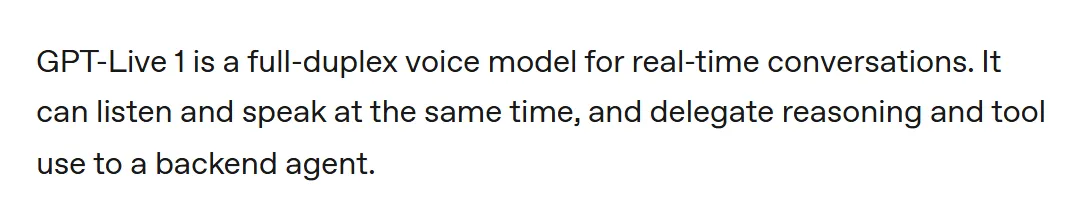
ההגדרה הרשמית מתוך תיעוד המודל
הרעיון המרכזי: שתי שכבות. GPT-Live-1 הוא שכבת הקול, ומאחורי הקלעים מודל אחר (למשל GPT-5.6 או GPT-6 Astra) מטפל בחלק המורכב: חיפוש, בדיקת זמינות, קריאה לכלים. השיחה נמשכת בזמן שהמודל השני עובד.
המספרים שפורסמו בהשקה
| מדד | GPT-Live-1 | המודל הקודם |
|---|---|---|
| השלמת משימות (Tau3: תעופה, קמעונאות, טלקום) | 83.6% | 45.7% |
| זמן תגובה בחילופי דיבור | 0.798 שניות | 1.41 שניות |
| דינמיקת שיחה (Conversational Dynamics) | 97.3% | - |
| אינטראקטיביות (Full Duplex Bench v1.5) | 80.1% | - |
המדידות של OpenAI, כשמאחורי הקלעים רץ GPT-6 Astra ברמת חשיבה בינונית
מה הוא יודע לעשות
- מקשיב ומדבר בו-זמנית: מזהה קטיעות, הנהונים (“אהה”, “כן”) ושתיקות, ולא מתבלבל מהן
- מעביר את החלק המורכב למודל אחר (Responses delegation) וממשיך לדבר בזמן שהוא עובד
- 12 קולות חדשים: Quartz, Ripple, Vesper, Willow, Stone, Gleam, Meridian, Bossa, Tempo, Beacon, Delta, Cinder
- תמלול מובנה (ASR) של מה שהמשתמש אמר, כולל keyword biasing למונחים שלכם
- זיהוי תורות מפורש (explicit turn detection) והתמודדות עם רעשי רקע בלי להקריא כל צעד
- שלושה מסלולי חיבור: WebRTC לדפדפן, WebSockets לשרת, ו-SIP לטלפוניה
- עובד גם עם Codex SDK כשהעבודה מאחורי הקלעים היא קוד
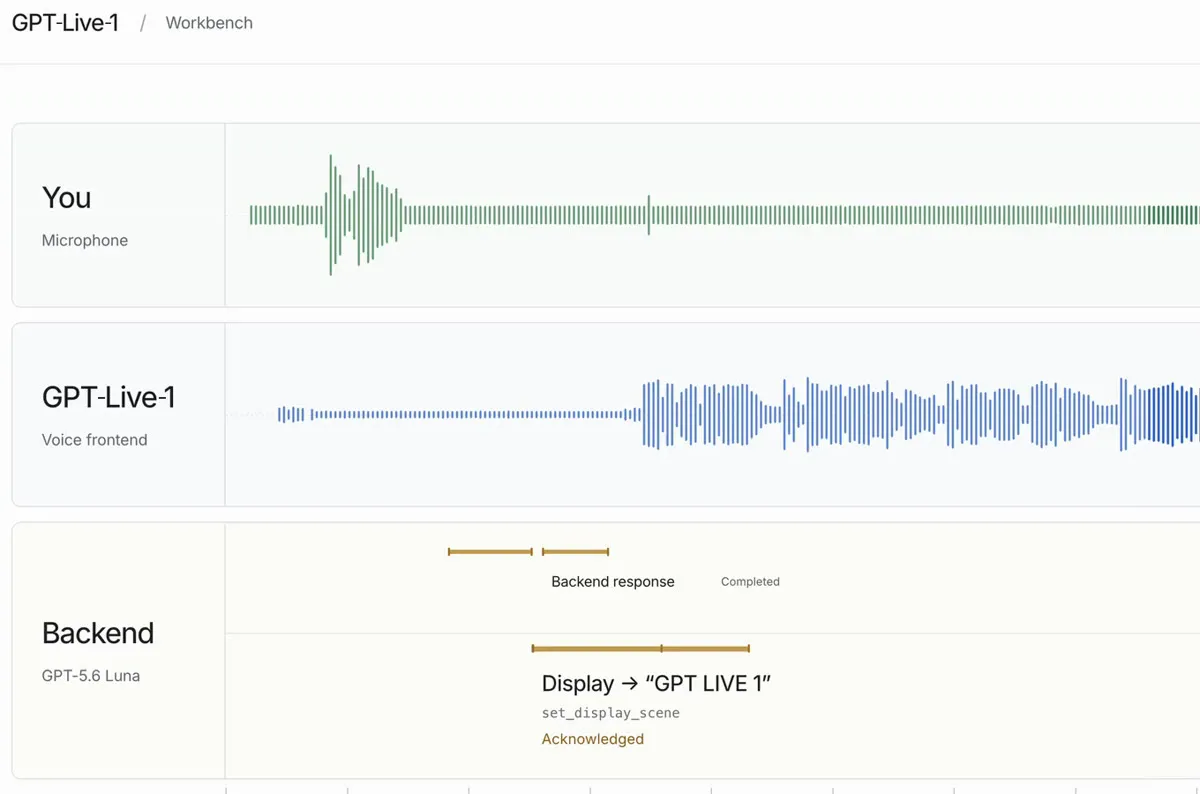
ה-Workbench מסרטון ההשקה: שלוש שורות, מה שאתם אומרים, מה שהמודל אומר, ומה שרץ מאחורי הקלעים
איך מתחילים
הדוגמה הרשמית של OpenAI היא דפדפן + שרת: השרת פותח את הסשן, הדפדפן מחבר מיקרופון ורמקול דרך WebRTC, ומודל Responses מאחורי הקלעים יודע לחפש ברשת.
שלב 1: לבחור מסלול חיבור
| מסלול | מתאים ל | איך זה עובד |
|---|---|---|
| WebRTC | אפליקציות קול בדפדפן | האודיו זורם ב-media tracks, והאירועים ב-data channel בפורמט JSON |
| WebSockets | אינטגרציה בצד השרת | סוקט אחד נושא גם אודיו וגם אירועי בקרה |
| SIP | שיחות טלפון נכנסות | הספק הטלפוני מנתב ל-OpenAI, ואתם מאשרים כל שיחה דרך webhook |
שלב 2: להגדיר את הסשן
זו ליבת ההגדרה. שימו לב לשדה delegation: הוא מגדיר איזה מודל עובד מאחורי הקלעים ומה ההנחיות שלו.
session = {
    "model": "gpt-live-1",
    "instructions": "You are answering an inbound support call.",
    "audio": { "output": { "voice": "marin" } },
    "delegation": {
        "type": "responses",
        "responses": {
            "model": "gpt-5.6-terra",
            "instructions": "<your backend prompt>",
            "tools": [ { "type": "web_search" } ]
        }
    }
}
יש שני מצבי delegation:
- responses: GPT-Live קורא בעצמו למודל שבחרתם, מעביר לו את הקשר השיחה ומחזיר את התוצאה לשיחה. המסלול הפשוט.
- client: האפליקציה שלכם מריצה את הסוכן או ה-workflow בעצמה ומחזירה ל-GPT-Live רק את מה שצריך להגיע לשיחה. יותר שליטה, יותר קוד.
שלב 3: לחבר את הדפדפן
בצד הלקוח פותחים חיבור WebRTC עם data channel בשם oai-events, שולחים את ה-offer לשרת שלכם, והשרת מחליף אותו ב-answer מול OpenAI:
const pc = new RTCPeerConnection();
const dc = pc.createDataChannel("oai-events");
const offer = await pc.createOffer();
await pc.setLocalDescription(offer);
// POST offer.sdp to your /session endpoint, then:
await pc.setRemoteDescription({ type: "answer", sdp: answerSdp });
dc.addEventListener("message", (e) => {
  const event = JSON.parse(e.data);
  // session.started, session.closed, ...
});
מחכים לאירוע session.started, מדברים, ומקבלים תשובה. האודיו עצמו עובר ב-media track של WebRTC, אין צורך לטפל בו ידנית.
שלב 4: טלפוניה (אופציונלי)
שיחות נכנסות מגיעות דרך SIP. הספק הטלפוני (Twilio, Telnyx, LiveKit או Daily) מנתב את השיחה לכתובת:
sip:$PROJECT_ID@sip.api.openai.com;transport=tlsOpenAI שולחת webhook בשם live.transport.incoming, ואתם מאשרים את השיחה עם ההגדרות של הסשן:
POST /v1/live/sessions/{session_id}/acceptשימו לב: שיחות יוצאות לא נתמכות בשלב זה, רק נכנסות. האודיו בטלפוניה הוא G.711 ב-8kHz.
כמה זה עולה באמת
זה הקאץ’ הראשון: המחיר שכולם מצטטים הוא רק על שכבת הקול.
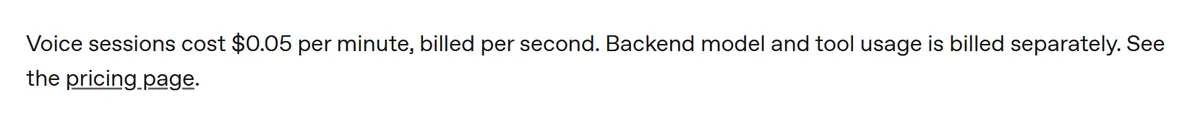
המשפט המדויק מתיעוד המודל
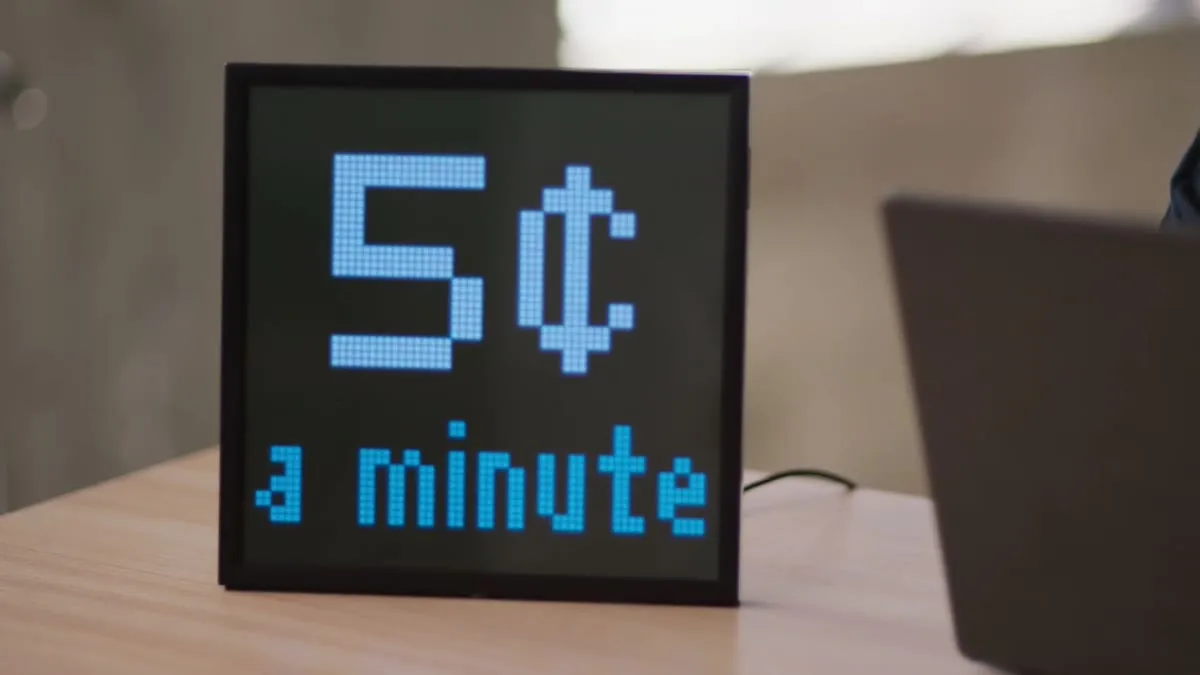
השלט מסרטון ההשקה של OpenAI
| מה | מחיר | הערות |
|---|---|---|
| שכבת הקול (gpt-live-1) | $0.05 לדקה | חיוב לפי שניות, גם כשאף אחד לא מדבר וגם כשהמודל מאחורי הקלעים עובד. חיבור WebRTC מוסיף 15 שניות אתחול |
| המודל מאחורי הקלעים | לפי טוקנים | מחויב בנפרד, כמו כל קריאת API רגילה: קלט, פלט, כלים, ו-cached input |
| כלים (web search וכו’) | לפי שימוש | בנפרד, לפי מחירון הכלים |
מחירי המודלים שרצים מאחורי הקלעים
מחירים לכל מיליון טוקנים, לפי מחירון ה-API (ספטמבר 2026):
| מודל | קלט | פלט |
|---|---|---|
| GPT-5-mini | $0.25 | $2.00 |
| GPT-5.1 | $1.25 | $10.00 |
| GPT-5.4 | $2.50 | $15.00 |
| GPT-5.6-sol | $4.00 | $20.00 |
| GPT-6 Astra | $10.00 | $50.00 |
עלויות ממוצעות: דוגמאות מחושבות
החישובים כאן הם הערכה שלי, לא מספר רשמי של OpenAI. ההנחה: שיחת תמיכה של 3 דקות, שבה המודל מאחורי הקלעים נקרא 3 פעמים, כל פעם עם כ-2,000 טוקני קלט ו-300 טוקני פלט.
| תרחיש | קול | מודל | סך הכול |
|---|---|---|---|
| שיחה של 3 דקות עם GPT-5-mini | $0.15 | $0.003 | $0.15 |
| שיחה של 3 דקות עם GPT-5.4 | $0.15 | $0.03 | $0.18 |
| שיחה של 3 דקות עם GPT-6 Astra | $0.15 | $0.10 | $0.25 |
| 1,000 שיחות בחודש, 3 דקות כל אחת, עם GPT-5.4 | $150 | $30 | $180 |
| שעה רצופה של שיחה, רק הקול | $3.00 | - | $3.00 |
המסקנה: ברוב התרחישים שכבת הקול היא ההוצאה הגדולה, והמודל מאחורי הקלעים מוסיף בין אחוזים בודדים לשני שליש, תלוי איזה מודל בחרתם. כל דקה שחוסכים בשיחה שווה 5 סנט.
איך לחסוך
הטיפים האלה מגיעים מדף אופטימיזציית העלויות של OpenAI:
- לאסוף את ההקשר לפני שהשיחה מתחילה (מי המשתמש, מה ההזמנה שלו), כדי שלא יצטרך לחזור על דברים ולחכות לחיפוש
- לקצר את זמן הכלים מאחורי הקלעים: מודל מהיר יותר או כלים שרצים במקביל. כל דקה שנחסכת = 5 סנט
- לסגור את סשן הקול כשמשימה ארוכה רצה ברקע, ולפתוח מחדש כשהיא מוכנה
- להשתמש ב-prompt caching על ההנחיות והגדרות הכלים שלא משתנות
- לבחור מודל לפי עלות השיחה כולה: מודל יקר שמסיים מהר יכול לצאת זול יותר ממודל זול שמושך את השיחה
- לזכור את מגבלת הסשנים המקבילים לפי ה-tier שלכם: 25 ב-Tier 1, 50 ב-Tier 2, 200 ב-Tier 3, 300 ב-Tier 4 ו-500 ב-Tier 5
מה זה לא
זה הקאץ’ השני: GPT-Live-1 הוא מנוע למפתחים, לא מוקד טלפוני מוכן. מה שמקבלים זה מודל וממשק. את כל השאר בונים:
- חיבור לספק טלפוניה ומספר טלפון
- הכלים שהמודל מאחורי הקלעים יכול להפעיל (בדיקת זמינות, CRM, הזמנות)
- הנחיות (prompts) לשתי השכבות, לקול ולמודל שמאחוריו
- לוגיקה של העברה לנציג אנושי, שעות פעילות ותיעוד השיחה
- מדידה: OpenAI פרסמה cookbook נפרד על איך מעריכים סוכן קולי לפני שמעלים לאוויר
עוד שתי מגבלות ששווה לדעת: שיחות יוצאות דרך SIP עדיין לא נתמכות, ותאריך הידע של המודל הוא יולי 2025, אז כל מידע עדכני צריך להגיע דרך הכלים.
לינקים
- ההכרזה הרשמית: openai.com/index/introducing-gpt-live-1-in-the-api
- מדריך ההתחלה: developers.openai.com/api/docs/guides/live
- דף המודל והמחיר: developers.openai.com/api/docs/models/gpt-live-1
- Delegation וכלים: developers.openai.com/api/docs/guides/live-delegation
- טלפוניה ו-SIP: developers.openai.com/api/docs/guides/voice-sip
- אופטימיזציית עלויות: developers.openai.com/api/docs/guides/voice-latency-cost
- מחירון ה-API המלא: developers.openai.com/api/docs/pricing
- סרטון ההשקה: x.com/OpenAIDevs
