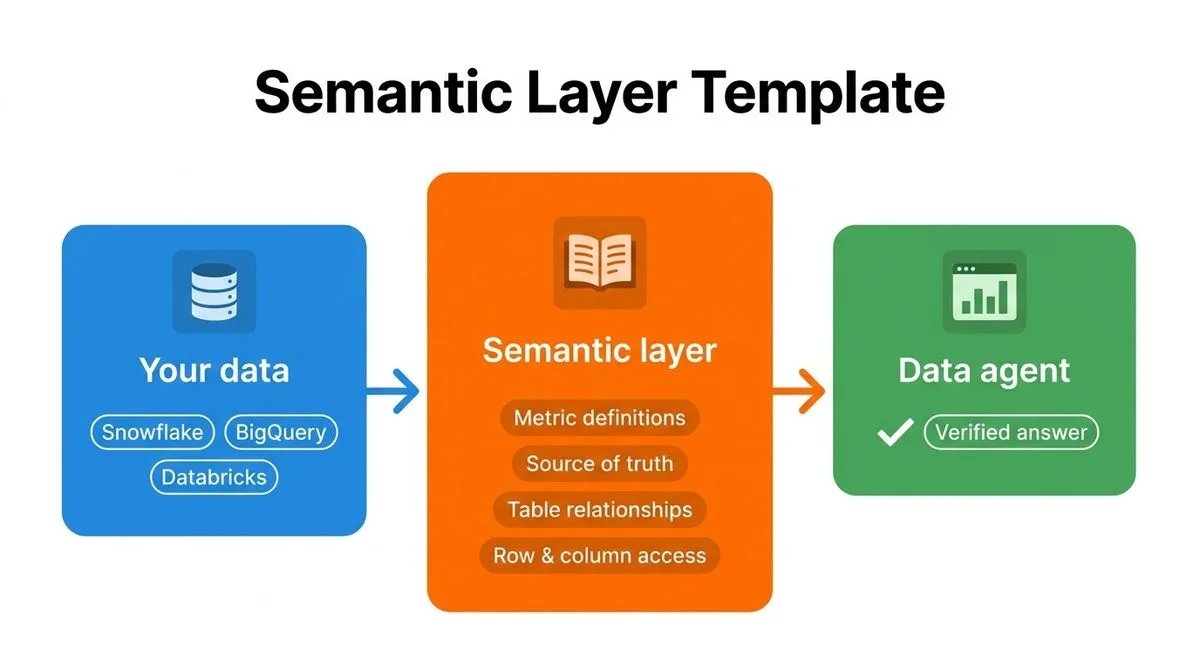
למה צריך את התבנית הזאת
שואלים את ה־AI למה המכירות ירדו, והוא עונה: “ההכנסות ירדו בשתיים עשרה אחוז”. נשמע מדויק. אבל בכל חברה יש כמה תשובות לשאלה מה זה הכנסה: לפני החזרות או אחריהן, לפי תאריך ההזמנה או לפי תאריך התשלום, כולל הזמנות בדיקה או בלי. כל הגדרה נותנת מספר אחר, והמודל לא יודע באיזו מהן אתם משתמשים.
ב-10 בספטמבר 2026 OpenAI השיקה את Data agent בתוך ChatGPT Work. הוא מתחבר למקורות הנתונים שהארגון אישר, חוקר מה השתנה ובונה דשבורד שאפשר להמשיך לשאול עליו שאלות, בלי לכתוב SQL. אבל כדי שהוא יבין את המספרים כמו שהעסק מבין אותם, הוא צריך שכבה סמנטית: מילון מוסכם שמסביר מה כל מדד אומר, איך מחשבים אותו ואיך הטבלאות קשורות זו לזו.
המדריך הזה הוא תבנית למלא. ארבע טבלאות, אחת לכל דבר שצריך לתעד לפני שמחברים את הסוכן, ובסוף רשימת בדיקות שמוודאת שהתשובות שלו נכונות ולא רק משכנעות.
מה זה Data agent ולאן הוא מתחבר
לפי ההכרזה הרשמית, הסוכן מתחבר למקורות מאושרים כמו Amazon Redshift, Datadog, Google BigQuery, ClickHouse, Databricks, MongoDB, Snowflake ועוד. הוא יכול להכניס לניתוח גם קבצים ומסמכים מתוך Google Drive ומתוך SharePoint.
מתוך ההכרזה של OpenAI: המקורות שהסוכן מתחבר אליהם
והחלק שהכי חשוב לנו: הסוכן משתמש במונחים העסקיים, בהגדרות המדדים, בחישובים המותאמים ובקשרים בין הנתונים של הארגון. ההקשר הזה מגיע משכבות סמנטיות וממקורות מהימנים כמו Databricks Genie Ontology, dbt, GitHub, Snowflake Horizon ודשבורדים של BI.
מתוך ההכרזה של OpenAI: מאיפה מגיע ההקשר העסקי
איך שלוש הגדרות נותנות שלוש תשובות
דוגמה פשוטה לחנות אונליין. אותו שבוע, אותה טבלת הזמנות, שלוש דרכים לספור “הכנסה”:
| ההגדרה | מה נכלל | התוצאה |
|---|---|---|
| כל ההזמנות שנפתחו | גם הזמנות שלא שולמו וגם הזמנות בדיקה | הכי גבוה |
| עסקאות ששולמו | רק מה שהכסף שלו נכנס, לפי תאריך התשלום | באמצע |
| עסקאות ששולמו, אחרי החזרות | מה שנשאר בפועל אחרי החזרים וביטולים | הכי נמוך |
אם בצוות המכירות סופרים לפי השורה הראשונה ובכספים לפי השלישית, הסוכן ייתן לכל אחד תשובה בטוחה ושונה. השכבה הסמנטית סוגרת את זה פעם אחת, לכולם.
התבנית: ארבעה דברים לתעד לפני שמחברים
מלאו כל טבלה. השורה הראשונה בכל אחת היא דוגמה, השורות הריקות הן בשבילכם. אל תנסו לכסות את כל העסק ביום אחד: מתחילים ב-5 המדדים שהכי הרבה אנשים שואלים עליהם.
1. הגדרת המדדים
לכל מדד: מה הוא אומר במילים, איך מחשבים אותו, מה לא נכלל ולפי איזה תאריך סופרים.
| מדד | הגדרה במילים | נוסחה | מה לא נכלל | תאריך קובע |
|---|---|---|---|---|
| הכנסה | עסקאות ששולמו, אחרי החזרות | סכום תשלומים פחות סכום החזרים | הזמנות בדיקה, חשבונות פנימיים | תאריך התשלום |
| לקוח פעיל | ביצע לפחות פעולה אחת ב-30 הימים האחרונים | ספירת לקוחות ייחודיים עם פעולה | משתמשי ניסיון שלא התחברו | תאריך הפעולה |
| לקוח חדש | לקוח שהתשלום הראשון שלו נפל בתקופה | ספירת לקוחות לפי תשלום ראשון | לקוח שחזר אחרי ביטול | תאריך התשלום הראשון |
שאלה שחייבת תשובה: באיזה אזור זמן סופרים? הזמנה שנכנסה ב-23:30 שעון ישראל יכולה לנפול ביום אחר אם המערכת סופרת לפי UTC.
2. מקור האמת
לכל מדד יש מקום אחד שבו המספר שלו נחשב “הנכון”. כשהסוכן והדשבורד הרשמי לא מסכימים, זה המקום שקובע.
| מדד | טבלה או מקור | הדשבורד הרשמי | מתי מתעדכן | מי מאשר שינוי |
|---|---|---|---|---|
| הכנסה | finance.fct_orders | Tableau / Weekly Sales | כל לילה | צוות הכספים |
3. הקשרים בין הטבלאות
כאן נולדות רוב הטעויות: חיבור לא נכון בין שתי טבלאות מכפיל שורות, וההכנסה פתאום גדלה פי שלושה.
| טבלה א | טבלה ב | מפתח החיבור | סוג הקשר | המלכודת |
|---|---|---|---|---|
| orders | payments | order_id | הזמנה אחת, כמה תשלומים | תשלום בתשלומים סופר את ההזמנה כמה פעמים |
4. מי רשאי לראות כל שורה ועמודה
לפי OpenAI, מנהלי הארגון בוחרים אילו חיבורים זמינים ולאילו תפקידים, והשאילתות מכבדות את ההרשאות הקיימות בחשבון המחובר, כולל הגבלות על טבלאות, שורות ועמודות. כלומר: ההרשאות צריכות להיות מוגדרות נכון במקור, לפני החיבור.
מתוך ההכרזה של OpenAI: ההרשאות נאכפות גם ברמת השורה והעמודה
| תפקיד | טבלאות מותרות | אילו שורות | עמודות חסומות |
|---|---|---|---|
| מנהל אזור | הזמנות, לקוחות | רק הלקוחות של האזור שלו | מספר כרטיס, טלפון, שכר |
איפה ההגדרות האלה כבר יושבות אצלכם
לא מדביקים את המילון לפרומפט בכל פעם. מחברים את הסוכן להגדרות שכבר קיימות בארגון, ובמקום שאין, כותבים אותן פעם אחת במקום מסודר.
| הכלי | מה יש שם |
|---|---|
| dbt | שכבה סמנטית שמגדירה מדדים מעל המודלים, כך שכולם מחשבים אותם אותו דבר |
| Snowflake Horizon | ב־Snowflake אפשר לשמור את ההגדרות בתוך המסד כ־Semantic View: טבלאות לוגיות, קשרים, עובדות, מימדים ומדדים |
| Databricks Genie | ההקשר העסקי של Databricks, שמופיע אצל OpenAI כמקור מהימן (Genie Ontology) |
| Power BI, Tableau | המודל הסמנטי והדשבורדים הקיימים. הסוכן יכול גם לבנות ולעבוד עם דשבורדים בכלים האלה |
| GitHub | תיעוד מאושר: קובץ הגדרות שעובר review כמו קוד, ומתעדכן כשהגדרה משתנה |
אין לכם אף אחד מאלה? התחילו בקובץ אחד ב־GitHub. כרטיס הגדרה לכל מדד, באנגלית פשוטה, למשל:
metric: revenue
definition: paid orders, after refunds
formula: sum(payment_amount) - sum(refund_amount)
excludes: test orders, internal accounts
date: paid_at (Asia/Jerusalem)
source_of_truth: finance.fct_orders
official_dashboard: Tableau / Weekly Sales
owner: finance team
בדיקת התשובות: לא לקבל מספר בלי לבדוק
החידוש הוא שלא צריך לדעת SQL כדי לחקור את הנתונים. אבל בלי שכבה סמנטית טובה, הסוכן ייתן תשובה משכנעת מאוד לשאלה שהוא פירש לא נכון. חמש בדיקות לפני שמעבירים מספר להנהלה:
- שאלו איזו הגדרה הוא הפעיל. “לפי איזו הגדרה של הכנסה חישבת, ולפי איזה תאריך?” אם התשובה לא תואמת לטבלה 1, עצרו.
- השוו לדשבורד הרשמי. בחרו שבוע אחד שהמספר שלו ידוע, ובדקו שהסוכן מגיע בדיוק לאותו מספר של מקור האמת מטבלה 2.
- בקשו לראות את הראיות. OpenAI מדגישה שאפשר לשאול שאלות המשך ולבדוק את הראיות שמאחורי כל ממצא. בקשו את הטבלאות והשאילתה שעליהן הוא נשען.
- נסו מקרה קצה. שבוע עם הרבה החזרות, או הזמנה שנכנסה בחצות. אם המספר לא זז כמו שהוא אמור, ההגדרה לא הגיעה לסוכן.
- בדקו הרשאות עם משתמש מוגבל. היכנסו עם תפקיד מטבלה 4 ובקשו נתון שהוא לא אמור לראות. התשובה הנכונה היא סירוב, לא מספר.
פרומפטים מוכנים לבדיקה
את הפרומפטים עדיף לכתוב באנגלית, כמו שהם מופיעים בהכרזה:
@Data Which definition of revenue did you use? List the table, the date column,
the time zone and every filter you applied.

@Data Recalculate last week's revenue and compare it to the Weekly Sales dashboard.
If the numbers differ, explain exactly why.

@Data Diagnose why weekly active users changed last week. Identify likely drivers,
compare against prior periods, and recommend the next checks.
הפרומפט האחרון לקוח מתוך רשימת הפרומפטים ש־OpenAI פרסמה בהשקה
איך מתחילים
- ב־ChatGPT Work, הסוכן מופיע בשם Data בתוך ספריית ה־Plugins.
- מנהל ה־workspace מתקין אותו לצוות דרך Workspace settings ואז Plugins, ומפעיל את חיבורי המקורות (למשל Databricks או Snowflake) וקובע מי יכול להשתמש בהם.
- אם הוא לא מותקן: מוצאים את Data בספריית ה־Plugins, לוחצים Install plugin ומשלימים את חיבור החשבון.
- פותחים שיחה עם @Data ושואלים שאלה עסקית.
הסדר הנכון: קודם ממלאים את ארבע הטבלאות ומחברים את ההגדרות, ורק אחר כך נותנים לכל הצוות לשאול.
טיפים
- התחילו ב-5 מדדים, לא ב-50. הכי הרבה טעויות מגיעות מהמדדים שכולם משתמשים בהם.
- לכל מדד יש בעלים אחד. בלי בעלים, ההגדרה תשתנה בשקט.
- כתבו גם מה לא נכלל. “בלי הזמנות בדיקה” חוסך יותר ויכוחים מכל נוסחה.
- שמרו את ההגדרות במקום שיש לו היסטוריה (GitHub, dbt), כדי לדעת מתי ולמה משהו השתנה.
- כשהסוכן והדשבורד לא מסכימים, אל תבחרו את המספר שנוח לכם. חזרו לטבלה 2.
- הריצו את חמש הבדיקות שוב אחרי כל שינוי בהגדרה.
מגבלות
- הסוכן זמין בתוך ChatGPT Work, ותלוי במה שמנהל הארגון התקין וחיבר.
- הוא לא ממציא את משמעות המדדים. אם אין הגדרה מוסכמת, הוא ינחש.
- עדויות הלקוחות בדף ההשקה הן של OpenAI והשותפים שלה, לא בדיקה עצמאית.
לינקים
- ההכרזה הרשמית: openai.com/index/put-data-to-work
- פוסט ההשקה: x.com/ChatGPT
- Snowflake Semantic Views: docs.snowflake.com
- dbt Semantic Layer: docs.getdbt.com
