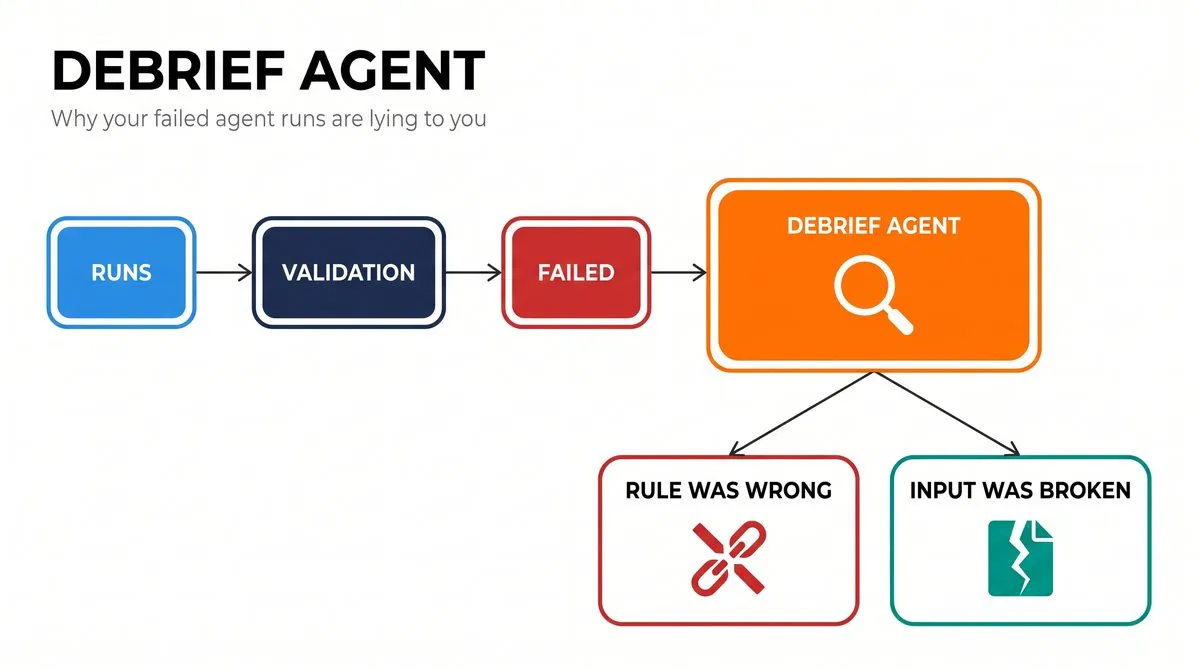
מה זה סוכן תחקור
סוכן תחקור הוא סוכן קטן ונפרד שרץ פעם ביום, עובר על כל הריצות שנפלו באותו יום, ולכל אחת עונה על שאלה אחת בלבד: הנפילה הזאת מוצדקת, או שהסוכן טעה?
הוא לא מתקן כלום. הוא לא מריץ מחדש. הוא רק מסווג. וזה בדיוק מה שהופך אותו לשימושי, ברגע שיש לכם סיווג יומי של הנפילות, אתם מגלים שחלק גדול מהן בכלל לא באשמת הסוכן.
למה זה חשוב: במערכת שמריצה מאות משימות ביום, לוח מחוונים שמראה כמה ריצות נפלו נראה תקין לגמרי. אף אחד לא פותח את הנפילות אחת-אחת. הן פשוט מצטברות, ומתוכן נבנית תמונה שגויה לגמרי של איפה הבעיה.
הבעיה: ריצה שנפלה לא אומרת שהסוכן טעה
כשמגדירים כללי ולידציה לכל סוג משימה, כל ריצה שלא עומדת בכלל נופלת. אבל נפילה היא לא ראיה, היא רק סימפטום. בפועל יש לפחות ארבע סיבות שונות שנראות בלוג בדיוק אותו דבר:
| הסיווג | מה זה אומר | מי הבעלים של הבאג |
|---|---|---|
AGENT_ERROR | הקלט היה תקין, הכלל הגיוני, והסוכן באמת הוציא פלט שגוי | הסוכן / הפרומפט |
RULE_WRONG | הסוכן עשה בדיוק מה שביקשו ממנו. הכלל עצמו לא מחזיק בשטח, או סותר את הקלט | המוצר / הביזנס |
BROKEN_INPUT | הקלט שהגיע ממערכת חיצונית היה שגוי, ריק או ישן. הסוכן נכשל בצדק לכאורה, אבל הבאג יושב במעלה הזרם | המערכת שמזינה אתכם |
UNKNOWN | אין מספיק מידע ברשומה כדי להכריע | הלוגים שלכם |
שתי השורות האמצעיות הן הרווח האמיתי. RULE_WRONG ו-BROKEN_INPUT הן נפילות שנראות כמו כשל של הסוכן ובעצם מצביעות על באג במקום אחר לגמרי, ובלי תחקור אף אחד לא היה מגלה אותן.
אנתרופיק מתארים בדיוק את אותה תופעה בהקשר של הרצות הערכה: ציון כישלון גורף הוא בדרך כלל סימן למשימה שבורה, לא לסוכן חלש. הדוגמה שהם נותנים, ציון של Opus 4.5 במבחן CORE-Bench קפץ מ-42% ל-95% אחרי שתיקנו באגים בבודק, מפרטים מעורפלים ומגבלות של סביבת ההרצה. המודל לא השתנה. רק ההגדרה של מה נחשב כישלון השתנתה.
מה צריך להכין לפני שמריצים
סוכן התחקור טוב בדיוק כמו הרשומה שאתם נותנים לו. לכל ריצה שנפלה תייצאו את השדות האלה:
| שדה | למה הוא נחוץ |
|---|---|
run_id | מזהה ייחודי, כדי שתוכלו לחזור לריצה |
task_type | סוג המשימה: הכללים שונים לכל סוג, וזה מה שמאפשר לזהות כלל שנשבר שוב ושוב |
input_payload | הקלט הגולמי כפי שהתקבל. זה השדה הכי חשוב: בלעדיו אי אפשר לזהות BROKEN_INPUT |
agent_output | מה הסוכן החזיר בפועל |
rule_id + rule_text | הכלל שהופר, בניסוח המלא שלו. בלי הטקסט אי אפשר לזהות RULE_WRONG |
validator_message | מה בדיוק אמר הוולידטור כשהפיל את הריצה |
source_system | מאיפה הגיע הקלט. זה מה שמאפשר להאשים מערכת חיצונית ספציפית |
הטעות הנפוצה: מזינים לסוכן רק את הודעת השגיאה. הודעת שגיאה תמיד תיראה כאילו הסוכן טעה, כי זה מה שהוולידטור חושב. בלי הקלט הגולמי אתם מקבלים סוכן שמאשר לעצמכם את מה שכבר האמנתם בו.
הפרומפט המלא: צעד אחרי צעד
זה הפרומפט המלא. שמרו אותו כקובץ בשם debrief-prompt.md והזינו אליו את הריצות של היום.
שלב 1: התפקיד וההגבלה
ההגבלה חשובה כמו התפקיד. סוכן שמותר לו גם לתקן יתחיל להמציא פתרונות במקום לסווג.
# ROLE
You are a failure-triage analyst for a production AI agent system.
You classify why each failed run failed. You do NOT fix anything,
you do NOT re-run anything, and you do NOT rewrite the agent prompt.
שלב 2: הקלט
# INPUT
You receive a JSON array of runs that FAILED validation today.
Each run has: run_id, task_type, input_payload, agent_output,
rule_id, rule_text, validator_message, source_system, timestamp.
שלב 3: השאלה האחת
שאלה אחת בלבד. סוכן שמתבקש להעריך חמישה ממדים בבת אחת נותן ציון ממוצע חסר ערך.
# THE ONE QUESTION
For every run, answer exactly one question:
was this failure justified, or is the failure itself the bug?
שלב 4: ארבעת הסיווגים
הגדרות חדות. אם ההגדרות חופפות, הסוכן יבחר תמיד את הראשונה ברשימה.
# VERDICTS - choose exactly one per run
AGENT_ERROR   The input was valid and the rule was reasonable.
              The agent genuinely produced a wrong output.
RULE_WRONG    The agent did exactly what it was asked to do.
              The rule does not hold in the real world for this
              task_type, or it contradicts the input it was given.
BROKEN_INPUT  The input from source_system was malformed, empty,
              stale or out of contract. The agent failed
              'correctly' but the real bug is upstream.
UNKNOWN       You do not have enough information to decide.
שלב 5: כללי השיפוט
החלק הזה הוא ההבדל בין סוכן שמנחש לסוכן שאפשר לסמוך עליו.
# RULES OF JUDGEMENT
1. Read input_payload BEFORE agent_output. Most misclassified
   failures are broken inputs that look like agent mistakes.
2. Quote the exact field or sentence that decided your verdict.
   A verdict with no quoted evidence is not allowed.
3. Judge one run at a time. Do not let a pattern you saw in run N
   leak into run N+1.
4. If rule_text is ambiguous or can be read two ways, that is
   RULE_WRONG, not AGENT_ERROR.
5. Return UNKNOWN when a field you need is missing from the
   record. Do not guess to avoid returning UNKNOWN, and do not
   return UNKNOWN merely to stay safe.
סעיף 5 הוא המלצה מפורשת של אנתרופיק: כשמשתמשים במודל כשופט, חייבים לתת לו דרך מילוט, הוראה להחזיר UNKNOWN כשאין לו מספיק מידע. בלי זה הוא ימציא הכרעה.
שלב 6: פורמט הפלט
אובייקט אחד לכל ריצה, ואז סיכום. שום טקסט חופשי מסביב.
# OUTPUT
Return JSON only. One object per run, then one summary object.

{
  "run_id": "...",
  "verdict": "AGENT_ERROR | RULE_WRONG | BROKEN_INPUT | UNKNOWN",
  "confidence": "high | medium | low",
  "evidence": "the exact field or sentence that decided it",
  "owner": "agent | product | upstream | logging",
  "suggested_action": "one sentence, imperative"
}

{
  "date": "YYYY-MM-DD",
  "total_failed": 0,
  "by_verdict": { "AGENT_ERROR": 0, "RULE_WRONG": 0,
                  "BROKEN_INPUT": 0, "UNKNOWN": 0 },
  "rules_to_review": ["rule_id ..."],
  "upstream_sources_to_review": ["source_system ..."]
}
איך מריצים את זה כל יום
שלושה שלבים. הכל רץ בלילה, אחרי שהיום נסגר.
1. מייצאים את הנפילות של היום
# any query that returns the fields from the table above
psql -At -c "\copy (select run_id, task_type, input_payload,
  agent_output, rule_id, rule_text, validator_message,
  source_system, created_at from runs
  where status='failed' and created_at::date = current_date)
  to 'failed-runs.json'"
2. מריצים את סוכן התחקור
במצב headless של Claude Code, כל מה שמוזרם ל-stdin נכנס כקלט לפרומפט:
cat failed-runs.json | claude --bare -p "$(cat debrief-prompt.md)" \
  --output-format json \
  > debrief-$(date +%F).json
הדגל --bare מבטיח שאותו סקריפט ייתן אותה תוצאה בכל מכונה, הוא מדלג על hooks, plugins, שרתי MCP וקבצי CLAUDE.md מקומיים. שימו לב שבמצב הזה צריך ANTHROPIC_API_KEY בסביבה.
רוצים פלט שמובטח לעמוד בסכמה? הוסיפו --json-schema והתוצאה תגיע בשדה structured_output:
cat failed-runs.json | claude --bare -p "$(cat debrief-prompt.md)" \
  --output-format json \
  --json-schema "$(cat debrief-schema.json)" \
  | jq '.structured_output' > debrief-$(date +%F).json
3. מתזמנים לסוף כל יום
# crontab -e   ->  every day at 22:00
0 22 * * *  /usr/local/bin/run-debrief.sh >> /var/log/debrief.log 2>&1
שתי דוגמאות מהשטח
דוגמה 1: הכלל הוא זה שטעה
הריצה: משימת חילוץ פרטי לקוח. הכלל דורש שדה טלפון בפורמט מקומי בן 10 ספרות. הריצה נפלה.
מה הסוכן החזיר: מספר תקין לחלוטין, אבל של לקוח מחו”ל, עם קידומת בינלאומית.
הוורדיקט: RULE_WRONG. הסוכן עשה בדיוק מה שביקשו. הכלל פשוט לא לקח בחשבון לקוחות בינלאומיים. הבאג הוא במפרט, לא בסוכן, וכל עוד לא מתחקרים, זה נספר כטעות של ה-AI.
דוגמה 2: הבאג ישב בקלט
הריצה: סיווג פנייה נכנסת. הכלל דורש שהסיווג יתאים לקטגוריה שקיימת בקטלוג. הריצה נפלה.
מה הסוכן החזיר: סיווג הגיוני לחלוטין ביחס לטקסט שהוא קיבל.
מה התחקור מצא: הטקסט שהגיע מהמערכת החיצונית היה קטוע באמצע משפט, שדה שנחתך בגלל מגבלת אורך בצד השולח.
הוורדיקט: BROKEN_INPUT. הסוכן נכשל בצדק לכאורה, אבל הבאג האמיתי הוא באינטגרציה. אף אחד לא היה בודק את זה, כי בלוח המחוונים זה נראה בדיוק כמו טעות של הסוכן.
טיפים
- הריצו על יום אחד, לא על חודש. תחקור של 40 נפילות נותן הכרעות חדות; תחקור של 1,200 נותן הכללות.
- תנו לו את הקלט הגולמי, לא רק את הודעת השגיאה. זה השדה שמפריד בין BROKEN_INPUT לבין האשמת הסוכן.
- שאלה אחת בכל קריאה. אם אתם רוצים גם לדרג חומרה, זו קריאה נפרדת עם רובריקה נפרדת.
- אל תתנו לו הרשאת כתיבה. סוכן תחקור שיכול לפתוח PR יתחיל לתקן במקום לסווג.
- כיילו פעם בשבוע: תייגו 20 נפילות ידנית והשוו לוורדיקטים שלו. אם הוא מסכים איתכם בפחות מ-80%, תחדדו את ההגדרות לפני שתסמכו על המספרים.
- שמרו את הפלט לאורך זמן. הערך האמיתי הוא בטרנד: כלל שחוזר כ-RULE_WRONG שלוש פעמים בשבוע הוא טיקט למוצר, לא אנקדוטה.
- אחוז UNKNOWN גבוה הוא לא כישלון של הסוכן אלא ממצא בפני עצמו: הלוגים שלכם חסרים שדות.
- התחילו על סוג משימה אחד. אחרי שהסיווג מדויק שם, הרחיבו.
מגבלות: מה זה לא
- זה לא מחליף מערך evals אמיתי. תחקור מסביר נפילות שכבר קרו; eval מונע רגרסיות לפני שהן מגיעות לפרודקשן.
- השופט עצמו יכול לטעות. בלי כיול מול תיוג אנושי המספרים שלו הם הערכה, לא אמת.
- הוא רואה רק מה שנכנס ללוג. נפילה שלא נרשמה, או שדה שלא ייצאתם, פשוט לא קיימים בשבילו.
- יש לזה עלות. ריצה יומית על מאות רשומות היא קריאת API אמיתית, הגבילו את מספר הרשומות ואת אורך ה-payload.
- אל תזינו לו PII גולמי. סננו או מסכו שדות רגישים לפני הייצוא.
לינקים
- המדריך של אנתרופיק לבניית evals לסוכנים: Demystifying evals for AI agents
- עקרונות לבניית סוכנים בפרודקשן: Building Effective Agents
- הרצה תכנותית של Claude Code: Claude Code headless mode
